
Read the book: «Виртуальный ты. Как создание цифровых близнецов изменит будущее человечества»

Всем врачам, ученым и инженерам, которые делают медицину по-настоящему прогностической
Peter Coveney, Roger Highfield
Virtual You. How Building Your Digital Twin Will Revolutionize Medicine and Change Your Life
Издание опубликовано с согласия и при поддержке The Curious Minds Agency, Louisa Pritchard Associates и The Van Lear Agency LLC
© 2023 by Peter Coveney and Roger Highfield
© 2023 by Princeton University Press
© Кедрова М. В., перевод на русский язык, 2024
© Издание на русском языке. ООО «Издательская Группа «Азбука-Аттикус», 2024
КоЛибри®
Вступительное слово
ВЕНКИ РАМАКРИШНАН
Физик Ричард Фейнман однажды сказал: «Чего не могу воссоздать, того не понимаю». Можно дополнить: «Чего не могу точно смоделировать, того не понимаю». Мы уверены, что понимаем, как самолеты летают и как ведут себя во время турбулентности или отказа двигателя, поскольку авиасимулятор может точно предсказать, что произойдет. Пилоты регулярно отрабатывают как обычные, так и непредвиденные ситуации, используя симуляторы и получая опыт, который могут так и не применить при управлении реальным самолетом.
Каковы перспективы моделирования себя на компьютере? На первый взгляд, это звучит скорее как научная фантастика, чем реальность. Однако в этой области был достигнут значительный прогресс. Данная книга знакомит с первыми шагами на пути к созданию собственного цифрового двойника и с трудностями в достижении этой цели, что само по себе является увлекательным путешествием.
Одна из ключевых тем книги – стремление видеть в биологии столько же теории, сколько и в физике. В 1976 г., сразу после аспирантуры, когда я ушел из физики, чтобы переквалифицироваться в биолога, я сразу заметил разницу. В физике, как и в химии, существовала высокоразвитая теория, которая помогала направлять и даже предсказывать эксперименты и поведение. Так, исходя из теоретических соображений, удалось изобрести транзисторы и лазеры и синтезировать совершенно новые соединения. В результате даже был построен ускоритель стоимостью в несколько миллиардов долларов для поиска теоретически предсказанного бозона Хиггса. Теория далека от совершенства. Например, не существует хорошей теории высокотемпературной сверхпроводимости, и мы не можем предсказать детальное сверхпроводящее поведение смеси металлов.
Биология в 1970-х гг., напротив, казалась в основном наблюдательной и эмпирической. У нее была одна всеобъемлющая теория – о естественном отборе, действующем как движущая сила эволюции всей жизни. Хотя эта теория обладала огромной объяснительной силой, ей не хватало детальной предсказательной силы. В биологии также было то, что я назвал бы локальными теориями или моделями: понимание того, как импульс распространяется по нерву, как работают различные биологические моторы или как человек реагирует на дозу адреналина. Но чего не было, так это всеобъемлющей способности предсказывать на основе набора начальных условий, как система (даже такая базовая единица, как клетка) будет вести себя с течением времени при произвольном наборе условий.
Проблема заключается в том, что количество факторов, участвующих в поддержании жизни, невероятно огромно. На каком-то базовом уровне существует наш геном, последовательность которого с большой помпой была раскрыта в начале этого столетия с перспективой вступить в новую эру биологии. Геном состоит из десятков тысяч генов, экспрессирующихся в разной степени и в разное время. Более того, экспрессия генов модулируется химическими метками на ДНК или связанными с ней белками, которые сохраняются при делении клеток, что является предметом эпигенетики. Наконец, экспрессия генов и их функции в клетке являются результатом их взаимодействия друг с другом и окружающей средой с образованием гигантской сети. Таким образом, любые надежды на возможность предсказывать на основе генов, зная их последовательность, оказались пустыми. Если это так даже для одной клетки, можно себе представить, насколько сложно теоретически предсказать будущее органа, не говоря уже о целом человеке.
Последние 20 лет биологическая революция XX в. дополнялась революцией в области вычислений и данных. Теперь у нас есть огромные объемы данных. Вместо одной последовательности человеческого генома мы имеем сотни тысяч, а также обширные последовательности геномов огромного числа видов. У нас есть карты транскриптомов, которые сообщают нам, какие гены экспрессируются (процесс, посредством которого информация, закодированная в гене, приводится в действие), в каких клетках и когда, и у нас есть карты интерактомов, отображающие взаимодействие между тысячами генов. Наряду с этим мы располагаем масштабными сведениями о физиологии и заболеваниях человека. У нас есть данные о личных характеристиках здоровья миллионов людей. Анализ и интерпретация всех этих данных находятся за пределами возможностей любого отдельного человека или даже группы. Но в то же время стремительно развивается наука о данных. Вычислительные методы, позволяющие связывать большие наборы данных и понимать их, постоянно совершенствуются.
Позволят ли эти достижения, в сочетании с активным развитием теории, в конечном итоге смоделировать форму жизни? В данной книге утверждается, что сочетание этих разработок даст нам возможность достичь амбициозной цели моделирования практически каждого органа и процесса в теле человека. Когда это будет сделано, мы сможем задавать следующие вопросы. Как этот человек отреагирует на конкретное лечение? В какой момент у него может развиться тяжелая болезнь? Можно ли предотвратить это, приняв меры на раннем этапе, и если да, то какие действия могут помочь? Как иммунная система одного человека отреагирует на инфекцию по сравнению с иммунной системой другого?
В книге описан прогресс практически во всех областях компьютерной биомедицины: от молекул и клеток до органов и человека. Когда я читал ее, у меня сложилось впечатление, что есть области, где цифровая симуляция – виртуальная копия реальности – уже почти существует. Одни цели кажутся достижимыми, но есть и такие, которые во многом напоминают научную фантастику. Да, в принципе, со временем их можно достичь, но практические трудности кажутся бесконечными и в настоящее время непреодолимыми. Ученые спорят о том, какие идеи – чистая фантазия, а какие – взгляд в наше будущее. Сами Ковени и Хайфилд проводят черту у цифрового сознания.
Те из нас, кто настроен более скептически, должны помнить, что у новых технологий есть две почти универсальные характеристики. Во-первых, на начальных этапах они обычно не работают должным образом, а их применение кажется очень узким и ограниченным. В результате, казалось бы, резкой трансформации (на самом деле являющейся результатом десятилетий работы) они внезапно становятся повсеместными и воспринимаются как нечто само собой разумеющееся. Мы увидели это на примере интернета, который в течение первых двух десятилетий был прерогативой горстки ученых в академических кругах и правительственных лабораториях, прежде чем стал константой в нашей жизни. Вторая особенность, на которую указал Рой Амара, заключается в том, что, когда дело доходит до прогнозирования эффекта и силы новой технологии, мы склонны переоценивать краткосрочную перспективу и недооценивать долгосрочную. Это часто приводит к большой шумихе, сменяемой неизбежным разочарованием, за которым в конечном итоге следует успех. Например, выстрелившая в 1970-х и 1980-х гг. идея искусственного интеллекта десятилетиями нас разочаровывала, но сегодня эта область невероятно успешна. Возможно, мы наблюдаем ту же ситуацию с беспилотными автомобилями.
Будет ли так же с идеей виртуальных людей – остается предметом споров, но в этой книге Ковени и Хайфилд предлагают нам увлекательный отчет об усилиях ученых по всему миру, которые сейчас работают ради достижения этой необычной цели.
В 2009 г. Венки Рамакришнан получил Нобелевскую премию за исследования рибосомы – молекулярной машины, превращающей гены в плоть и кровь.
Введение
Представьте себе виртуального человека, состоящего не из плоти и костей, а из битов и байтов, и не просто человека, а виртуальную версию вас, точную во всем, от биения сердца до букв ДНК-кода.
ПРЕМЬЕРА ФИЛЬМА «МУЗЕЙ НАУКИ», ЛОНДОН
В стенах часовни XIX в. на окраине Барселоны начинает биться сердце. Оно не настоящее, а виртуальная копия того, что бьется в груди пациента. Благодаря миллиардам уравнений и 100 миллионам участков смоделированных клеток цифровой двойник бьется со скоростью около одного удара в час, тестируя методы лечения – от лекарств до имплантатов.
Несмотря на то, что часовня Торре Жирона была секуляризирована десятилетия назад, над входом до сих пор красуется крест. В архитектуре романтизма чувствуется высшая сила и цель. Когда солнечный свет струится сквозь витражные окна, вы предстаете перед огромной комнатой из стекла и стали, внутри которой стоят три ряда черных шкафов, усеянных зелеными огнями.
Это MareNostrum (римское название Средиземного моря), суперкомпьютер в кампусе Политехнического университета Каталонии, который Питер Ковени и коллеги со всей Европы используют для моделирования электрических, химических и механических процессов в человеческом организме. На вид симуляции не отличить от настоящих, будь то трепещущее сердце или наполняющееся воздухом легкое. Однако гораздо важнее то, что эти виртуальные органы ведут себя как настоящие.
Чтобы показать ошеломляющий диапазон и потенциал виртуальных исследований человека, мы использовали MareNostrum для создания фильма с помощью моделирования, запущенного на других суперкомпьютерах, в частности SuperMUC-NG в Германии (суффикс MUC относится к коду близлежащего аэропорта Мюнхена). Работая с международной командой, мы хотели, чтобы фильм «Виртуальные люди» продемонстрировал, куда наши усилия по созданию тела in silico1 могут привести медицину.

Рисунок 1. Кадр из фильма «Виртуальные люди» (CompBioMed и Суперкомпьютерный центр Барселоны)
В сентябре 2017 мы провели премьеру в огромном кинотеатре IMAX Музея науки в Лондоне, вместе с Фернандо Куккетти и Гильермо Марино, нашими коллегами из Суперкомпьютерного центра Барселоны. Несмотря на то, что мы работали над фильмом несколько месяцев, мы все равно затаили дыхание, увидев бьющееся виртуальное сердце размером с четыре двухэтажных автобуса.
SuperMUC-NG и MareNostrum 4 – две из примерно нескольких сотен огромных вычислительных машин, разбросанных по всему миру. Эти машины используются для моделирования космоса, понимания закономерностей природы и решения основных задач, стоящих перед нашим обществом, таких как изучение изменения климата, разработка низкоуглеродных источников энергии и моделирование распространения виртуальных пандемий.
Подобно великим средневековым соборам, воздвигнутым архитекторами, каменщиками, геометрами и епископами, чтобы дать человечеству представление о бесконечности, суперкомпьютеры – это соборы информационной эпохи, где новые миры и даже целые вселенные бесконечного разнообразия могут быть смоделированы внутри великих двигателей логики, алгоритмов и информации.
Они также могут воссоздать внутренние миры человеческого тела, и не любого или «среднего» тела, а тела конкретного человека: от тканей и органов до молекулярных машин, работающих внутри клеток, их составных белков и ДНК. Конечная цель этой работы – запечатлеть на компьютере жизненные ритмы, закономерности и нарушения, причем не просто какой-то среднестатистической жизни, а одного конкретного тела и одной конкретной жизни – вашей2.

Рисунок 2. Суперкомпьютер MareNostrum (wikimedia commons: Gemmaribasmaspoch. cc-BY-SA-4.0)
На премьере к нам присоединились коллеги, разработавшие виртуальные сердца, артерии и вены, а также скелет и его мускулатуру. На великолепном экране IMAX в Музее науки переполненная аудитория увидела будущее, когда лекарства можно будет разрабатывать с учетом индивидуальных потребностей каждого пациента, когда мы сможем визуализировать движение мутировавшего белка в организме, отследить турбулентный поток частиц лекарства глубоко в легких, изучить волны клеток крови через мозг и смоделировать давление и напряжение, оказываемые на ослабленные кости.
Расцвет цифровых двойников
В технике виртуальные копии известны как цифровые двойники. Эту концепцию обычно приписывают статье Джона Викерса и Майкла Гривза из Мичиганского университета от 2002 г.3, в которой говорилось о «модели зеркальных пространств». НАСА ввело термин «цифровой двойник» в 2010 г.4 и применило к космическим кораблям5. Однако истоки двойников можно найти гораздо раньше. Многие в качестве яркого примера ссылаются на лунную программу «Аполлон»: наземные симуляторы использовались в качестве аналоговых двойников космических кораблей. Этот подход был использован в 1970 г., чтобы помочь успешно вернуть трех астронавтов злополучной миссии «Аполлон-13» после взрыва в 200 000 милях от Земли6.
Сегодня цифровые двойники хорошо зарекомендовали себя. Многие промышленные процессы и машины слишком сложны для понимания одним мозгом, поэтому эксперименты с цифровыми двойниками облегчают изучение и понимание их поведения7. Уроки, извлеченные таким образом, преобразуют будущее производства и, ускоряя автоматизацию, меняют будущее труда. Цифровые копии машин и даже целых заводов помогают предвидеть препятствия, совершенствовать конструкции и предотвращать ошибки еще до их возникновения.
Цифровые двойники используются для оптимизации цепочек поставок и планировки магазинов. General Electric использовала двойника для повышения эффективности на алюминиевом заводе в Индии; двойник маршрута предполагаемой железнодорожной линии на северо-западе Англии – в виде 18 миллиардов точек данных, собранных дронами, – был создан, чтобы помочь управлять этим огромным транспортным проектом; «фабрика будущего» в Австралии отточила виртуальную копию роботизированной рабочей станции, прежде чем создать настоящую; инженеры используют цифровые двойники, чтобы оценить срок службы реактивного двигателя и способы его эффективного обслуживания. Цифровые двойники использовались для создания ветряных турбин, нефтяных вышек, автомобилей, реактивных двигателей, самолетов, космических кораблей и многого другого. Некоторые считают, что цифровые двойники городов являются ключом к будущему городскому планированию.
Цифровые двойники появляются и в медицине благодаря революции данных в биологии. Одним из легионов людей, анализирующих данные о здоровье, является Лерой Худ из Института системной биологии в Сиэтле. Один из самых влиятельных современных биотехнологов, Худ десятилетиями работал на передовых позициях в области медицины, инженерии и генетики, начиная с первой встречи по программе генома человека в 1985 г. В 2015 г. он запустил проект, собравший множество данных о 5000 пациентах за пять лет. Все их данные хранились в том, что Худ называет «облаками личного здоровья»8. Анализ облака пациента может выявить характерные сигналы того, что Худ называет «пред-предболезнью», которые врачи могут использовать, чтобы предвидеть проблему, а затем вмешаться для поддержания здоровья.
Худ говорит о «научном благополучии», которое «использует личные, плотные, динамические облака данных для количественной оценки и определения здоровья, а также выявления отклонений от состояния здоровья в сторону болезни». Живое воплощение его подхода, 82-летний мужчина, был в отличной форме («Я не планирую выходить на пенсию»), когда мы говорили с ним о его видении будущего «4П», где лечение будет прогнозирующим, профилактическим, персонализированным и партиципаторным. Моделирование тела поможет вступить в это будущее, выявив закономерности в данных пациента.
В действительности, конечно, мы обходимся неполным пониманием и неполными данными. Но, как показали достижения в области прогнозирования погоды, эти недостатки можно преодолеть и сделать полезные прогнозы. Мы прошли долгий путь с 1922 г., когда британский математик Льюис Фрай Ричардсон (1881–1953) в замечательной книге «Прогноз погоды с помощью численного метода» (Weather Prediction by Numerical Process) изложил идею фантастической фабрики прогнозов, где тысячи человеческих «компьютеров», использующих логарифмические линейки и калькуляторы, координируются «дирижером». Ричардсон размышлял: «Возможно ли будет когда-нибудь в туманном будущем проводить вычисления быстрее, чем меняется погода?» Но даже он признал, что фабрика прогнозов была всего лишь мечтой.
Столетие спустя его необыкновенное видение стало реальностью. Суперкомпьютеры могут делать прогнозы на несколько дней вперед с достаточной точностью, постоянно обновляя сложные компьютерные модели данными с орбитальных спутников, буев, самолетов, кораблей и метеостанций.
Типичная модель прогнозирования опирается на систему уравнений, позволяющую моделировать: будет идти дождь или сиять солнце. Существует уравнение для импульса, плотности и температуры в каждой из трех фаз воды (пар, жидкость и твердое состояние), а также, возможно, для других химических переменных, таких как озон, который поглощает вредное ультрафиолетовое излучение. Во второй главе мы объясняем, почему эти нелинейные дифференциальные уравнения, особенно уравнения в частных производных, управляют климатической системой. В целом, чтобы смоделировать планету с разрешением, составляющим в настоящее время около 60 км, требуются миллиарды уравнений9. Модель должна учитывать постоянно меняющиеся термодинамические, радиационные и химические процессы, действующие в масштабах от сотен метров до тысяч километров и от секунд до недель10. Это представляет собой проявление силы моделирования, которое, как утверждают некоторые, уже приближается к сложности, необходимой для моделирования человеческого мозга.
Благодаря потоку биомедицинских данных, доступных сегодня, а также все более мощной теории и расчетам, мы считаем, что в биологии моделирование произведет революцию так же, как и в метеорологии. Американский метеоролог Кливленд Эббе (1838–1916) однажды заявил, что прогресс в его области зависит от «посвящения в эту науку физиков и математиков»11. Вторя его видению прогнозирования из 1895 г., мы с нетерпением ждем того дня, когда будет недостаточно знать, что кто-то нездоров, – мы хотим иметь возможность понять, заболеет ли он в будущем и почему, чтобы мы могли его вылечить.
Оптимизм в отношении потенциала цифровых двойников в медицине подкрепляется нашей нынешней способностью прогнозировать погоду, которая поразила бы Эббе. Мы воспринимаем ежедневные прогнозы как нечто само собой разумеющееся, но этот подвиг на стезе предсказания поистине выдающийся. Маркус Коверт из Стэнфордского университета, разработавший виртуальные клетки, заметил: «Прогнозирование таких бедствий, как ураган «Сэнди», за десять дней до выхода на берег – с соответствующей эвакуацией сотен жителей, спасающей как жизни, так и имущество, – возможно, стоит причислить к величайшим техническим триумфам в истории человечества»12.
Что касается прогнозов климата, разрабатываются планы по созданию «цифрового двойника» Земли, который будет моделировать атмосферу, океан, ледники и сушу с разрешением в 1 км, предоставляя прогнозы рисков наводнений, засух и пожаров, а также океанских вихрей, которые перемещают тепло и углерод по планете. Эта европейская модель (Destination Earth) объединит другие данные, такие как использование энергии, структуру дорожного движения и перемещения людей (отслеживаемые с помощью мобильных телефонов), чтобы показать, как изменение климата повлияет на общество и как общество может изменить его траекторию во времени, которое некоторые уже называют антропоценом – геологической эпохой, когда человеческая деятельность оказывает значительное влияние на нашу планету13.
Подробности создания цифрового двойника планеты Земля ошеломляют. Возьмем, к примеру, облака. Они состоят из воды, которая также является основным компонентом человеческого тела (около 68 %)14. Однако, в отличие от нас, облака кажутся простыми – огромные шлейфы капель воды или кристаллов льда, плывущие по небу. Их формирование имеет решающее значение для нашей способности предсказывать погоду, важно для нашего понимания последствий глобального потепления и занимает центральное место в спорных схемах сдерживания изменения климата с помощью геоинженерии15.
От пучков кучевых облаков причудливых форм до огромных серых пластов – облака являются прекрасным примером того, как сложность может возникнуть из простоты – капель воды, переносимых воздушными потоками в результате конвекции. Когда эти капли конденсируются внутри облаков, выделяется немного тепла, что поддерживает облака в воздухе. На больших высотах, где температура падает значительно ниже нуля, капли превращаются в кристаллы льда, придавая облакам тонкий, перистый вид.
Внутри облака процессы наименьшего масштаба управляют образованием капель. Но, хотя эти особенности и взаимодействия микроскопичны, они имеют крупномасштабные макроскопические эффекты. Чем меньше и многочисленнее капельки, тем сильнее рассеивается свет. На уровне микрометров турбулентность ускоряет образование облаков и вызывает ливни16. Крупномасштабные движения воздуха могут создать обширные облачные системы, которые могут охватить весь континент. Отражая свет в космос, облака могут охлаждать поверхность Земли, поэтому некоторые считают, что их следует взращивать, чтобы помочь обуздать безудержное глобальное потепление17.
По существу, все законы, лежащие в основе формирования облаков, известны, поэтому мы должны быть в состоянии представить, как они развиваются, с помощью известных математических уравнений. Мы надеемся добиться того же для виртуальных людей, вплоть до последней молекулы воды. Это кажется настоящей фантастикой, но оптимизм по поводу способности математики описать теплый, сложный и динамичный мир тела, существует не первое столетие. Английский врач Уильям Гарвей (1578–1657) в своей демонстрации кровообращения опирался на расчеты18, а в 1865 г. французский физиолог Клод Бернар (1813–1878) заявил, что «применение математики к природным явлениям является целью всей науки»19.
Наша способность создать виртуальную копию человека зависит от описания тела языком математики. Несмотря на то что работа еще продолжается, уравнения, написанные с использованием математического анализа и выражающие скорость изменений, уже могут отображать сложные процессы, открытые молекулярными биологами, клеточными биологами и многими другими представителями биологических наук. Эти математические выражения – обычные дифференциальные уравнения и уравнения в частных производных – могут в любой момент описать, как меняется кровяное давление в зависимости от того, где в организме вы проводите измерения, или движение электрического импульса, проносящегося по нейрону в мозге, или насколько быстро вирус проникает в дыхательные пути человека.
Чтобы заставить эти уравнения работать, все, что нужно для начала расчетов, – это граничные условия для рассматриваемой задачи. Под условиями может подразумеваться состояние нейрона или инфицированной клетки в данный момент или в различные промежутки времени, скорость их изменения в различные моменты времени или верхний и нижний пределы данной величины. Эти условия привязывают математику к реальности, поэтому мы можем делать прогнозы о теле или «медицинские прогнозы» по аналогии с погодой.
Но хотя мы признаем, что законы природы универсальны, в ключевом и практическом смысле науки о жизни, – под которыми мы подразумеваем биологию и медицину, – весьма отличаются от физических наук – физики и химии, – которые мы используем для описания облаков. Они более эмпиричны, больше зависят от измерений и экспериментов и до сегодняшнего дня меньше всего зависели от теоретического понимания.
Теория (то есть математическое представление законов природы) в медицине и биологии играет меньшую роль. Даже теория эволюции Дарвина – Уоллеса, которую некоторые считают величайшей научной теорией из всех, не допускает математического описания. Может показаться шокирующим, но реальность такова: хотя с XIX в., когда Грегор Мендель изучал горох, были сделаны основные предсказания о закономерностях наследования, ход эволюции невозможно предсказать каким-либо количественным способом20.
Некоторые влиятельные фигуры слишком хорошо осведомлены об этом недостатке. Пол Нерс, директор Института Фрэнсиса Крика в Лондоне и бывший помощник редактора Journal of Theoretical Biology, рассказал нам, как ему надоело читать статьи, в которых умные технологии используются для проведения измерений, но «почти не приводят к каким-либо значимым выводам»21. В обзорной статье для журнала Nature он процитировал Сиднея Бреннера (1927–2019), своего старого друга и коллегу-нобелевца: «Мы тонем в море данных и жаждем знаний»22. Нерс жаловался, что важностью теории и принципами жизни пренебрегают в пользу зубрежки фактов, установок и информации. В биологии «есть идеи, так почему же мы о них не говорим?»
Однако биология, как и остальная наука, несомненно, подчиняется законам природы. Конечно, существуют области запретные по моральным и этическим соображениям, основанным на человеческих аргументах, но есть абсолютно все основания полагать, что мы должны быть в состоянии понять конкретный научный аспект того, как работает организм, и выразить это понимание в математической форме. Чтобы создать виртуального человека, биологии нужно выйти за рамки нынешнего использования теории для проведения апостериорных рационализаций после самих исследований и перейти к использованию теории для руководства экспериментами и прогнозирования.
Объединяя науку
Наука балканизирована. Идея разделения академических исследователей на племена восходит к Древней Греции, где жили Сократ (ок. 469–399 гг. до н. э.), его ученик Платон (ок. 428–347 гг. до н. э.) и, в свою очередь, ученик Платона Аристотель (384–322 гг. до н. э.)23. Однако через несколько десятилетий Тимон из Флиунта (ок. 320–230 гг. до н. э.) жаловался на ссоры «книжных монастырей» в Александрийском музее. К XVI в. Фрэнсис Бэкон (1561–1626) и другие философы оплакивали раскол человеческого знания.
К середине XIX в. дисциплинарные границы укоренились, каждая обладала своими обычаями, языком, потоками финансирования, учреждениями и практикой. В «Виртуальный ты» мы намерены показать, что сегодняшние исследования – больше, чем просто набор разрозненных усилий. Это грандиозная и взаимодополняющая мозаика данных, моделей, механизмов и технологий. Проступает общая картина того, как работает человеческое тело.
Поскольку не существует единственно верного восприятия человеческого тела, важна каждая точка зрения из каждой дисциплины. Они дополняют друг друга, и, если последовательно объединять их, могут возникнуть новые замечательные идеи. Если мы посмотрим, например, на великую революцию в молекулярной биологии, произошедшую в 1950-х гг., когда физики и химики занялись биологией, а биологи использовали методы, разработанные физиками, то увидим, что этот жизненно важный атомный взгляд на белки, ферменты и другие молекулы живых существ прекрасно дополняет существующие представления о наследственности и эволюции, создавая мощную унификацию знаний, известную как совпадение индуктивных обобщений.
Простая идея, лежащая в основе этой книги, заключается в том, что конвергенция многих отраслей науки – данных о пациентах, теории, алгоритмов, искусственного интеллекта и мощных компьютеров – ведет медицину в новом направлении, количественном и прогнозирующем. Мы покажем, как математика может охватить необычайный спектр процессов, происходящих в живых существах, взвесим разработки в области аппаратного и программного обеспечения, а затем покажем, как человеческое тело можно изобразить in silico, держа в руках цифровое зеркало, отражающее наше возможное будущее.
Эта история основана на междисциплинарных идеях, которые мы изложили в наших предыдущих книгах The Arrow of Time24 и Frontiers of Complexity25. В первой мы обсуждали, как решить глубокую проблему, лежащую в основе науки: время представляется по-разному во многих теориях и масштабах, от микроскопического до макроскопического. В последней мы показали, как сложность математики, физики, биологии, химии и даже социальных наук меняет не только наше представление о Вселенной, но и сами предположения, лежащие в основе традиционной науки, и насколько важны компьютеры, если нам предстоит изучить и понять эту сложность. Нигде это не является более актуальным, чем в попытках создать виртуального человека. В «Виртуальный ты» мы объединяем эти идеи в широкий спектр исследований, как исторических, так и современных.
Виртуальный ты
Это первый отчет глобальной кампании по созданию виртуального человека, ориентированный на широкого читателя. За последние два десятилетия сотни миллионов долларов были потрачены на работу в рамках таких инициатив, как международный проект «Физиом»26, «Цифровой двойник онкологического пациента» в США27, европейский «Виртуальный физиологический человек»28, проект «Человеческий мозг»29 и еще один общеевропейский проект, возглавляемый Университетским колледжем Лондона, в который мы оба вносим свой вклад, – «Вычислительная биомедицина», или сокращенно CompBioMed.
Все объединяет одна цель. Как было заявлено на одном из семинаров, состоявшемся в Токио: «Пришло время начать грандиозный проект. В течение следующих 30 лет будет создана всеобъемлющая, основанная на молекулах, многомасштабная вычислительная модель человека («виртуальный человек»), способная с разумной степенью точности моделировать и прогнозировать последствия большинства отклонений, имеющих отношение к здравоохранению»30. Видение было обнародовано более десяти лет назад – в феврале 2008 г., – и это будущее быстро приближается.
На следующих страницах мы отправим вас в фантастическое путешествие по телу, его системам органов, клеткам и тканям, а также по деформируемым белковым машинам, которые всем управляют. Мы надеемся убедить вас, что в ближайшие десятилетия виртуальные двойники клеток, органов и популяции виртуальных людей будут формировать здравоохранение. Этот организующий принцип медицины XXI в. впервые позволит врачам предвидеть и предсказывать, что вас ждет, включая эффекты предлагаемых методов лечения. Это резко контрастирует с сегодняшним подходом, при котором врачи, по сути, действуют с оглядкой на то, что случилось с похожими (хотя и неидентичными) пациентами в аналогичных (хотя и неидентичных) обстоятельствах.
В долгосрочной перспективе виртуальные клетки, органы и люди – наряду с популяциями виртуальных людей – помогут превратить нынешнее поколение универсальной медицины в медицину, по-настоящему персонализированную. Ваш цифровой двойник поможет понять, какие формы питания, физических упражнений и образа жизни обеспечат вам самое здоровое будущее. В конечном счете появление цифровых двойников может проложить путь к методам улучшения вашего тела и будущего. Как мы обсудим в заключительной главе, виртуальные люди будут держать зеркало, чтобы отразить лучшую версию вас.
Первые четыре главы посвящены фундаментальным шагам, необходимым для создания цифрового двойника: сбору разнообразных данных о теле (глава первая); разработке теории, чтобы разобраться во всех этих данных (глава вторая), использованию математики, чтобы понять фундаментальные ограничения моделирования, использованию компьютеров, чтобы вдохнуть жизнь в математическое понимание человеческого тела (глава третья); объединению естественного и искусственного интеллекта для интерпретации данных и формирования нашего понимания (глава четвертая).
В главах с пятой по восьмую мы показываем последствия этих шагов и начинаем создавать цифрового двойника – от виртуальных инфекций (глава пятая) до клеток, органов, метаболизма и тел. Попутно, в шестой главе, мы встречаемся с пятым шагом, необходимым для создания виртуального человека. Можем ли мы объединить различные математические модели разных физических процессов, происходящих в разных областях пространства и времени внутри тела? Мы можем, и возможность настраивать виртуальное сердце так, чтобы оно соответствовало сердцу пациента, является одним из выдающихся примеров (глава седьмая), наряду с моделированием тела и его систем органов (глава восьмая). В девятой главе мы обсуждаем «Виртуального тебя 2.0», когда следующее поколение компьютеров преодолеет недостатки нынешнего поколения «классических» цифровых компьютеров.
В последней главе мы рассматриваем множество возможностей, а также этические и моральные проблемы, которые создадут виртуальные люди. Цифровые двойники бросят вызов тому, что мы подразумеваем под такими простыми терминами, как, например, «здоровый». Действительно ли вы здоровы, если ваш цифровой двойник предсказывает, что без лечения или изменения образа жизни вы не проживете свою потенциальную продолжительность жизни? Вы можете чувствовать себя «хорошо», но действительно ли вы здоровы, если моделирование предполагает, что вам суждено провести в доме престарелых на десять лет дольше, чем необходимо? Если виртуальный человек может стать субстратом человеческой мысли, как мы будем относиться к нашей цифровой копии? Наконец, в приложении мы рассматриваем провокационный вопрос, возникающий при использовании компьютеров для моделирования мира: возможно ли воссоздать фундаментальную физику космоса с помощью простых алгоритмов?

Рисунок 3. Виртуальный анатомический близнец. Одна из подробных анатомических моделей высокого разрешения, созданных на основе данных магнитно-резонансной томографии добровольцев (IT’IS Foundation)
Итак, переходим к первой из наших основополагающих глав. Она ставит самый главный вопрос: если мы хотим создать цифровых двойников, насколько хорошо нам нужно знать самих себя? Чтобы создать виртуального человека, нам необходимо понять, какого рода данные и какого объема достаточно для анимации цифрового двойника с помощью компьютера.
Как однажды заметил Аристотель, познание себя есть начало всякой мудрости.
Глава 1
Мерило себя
«Искусство Картографии достигло у них в Империи такого совершенства, что Карта одной-единственной Провинции занимала целый Город, а карта Империи – целую Провинцию. Со временем эти Несоразмерные Карты нашли неудовлетворительными, и Коллегия Картографов создала Карту Империи, которая была форматом в Империю и совпадала с ней до единой точки».
Чтобы создать виртуальную версию тела, первым делом нужно собрать достаточно личных данных. Существует множество потенциальных источников для получения этих данных: ультразвуковое сканирование сердца и других внутренних органов или визуализация всего тела с использованием рентгеновских лучей или магнитно-резонансной томографии (МРТ). Вы можете использовать различные – омы, будь то детальная последовательность ДНК (геном), химические детали вашего метаболизма (метаболом) или весь набор белков (протеом). Ваши личные данные могут включать в себя и незнакомые характеристики (такие как особая форма важного фермента), и более рутинные измерения (например, артериальное давление), а также «цифровые биомаркеры», которые можно собирать с помощью носимого устройства, будь то телефон, часы или рубашка из «умного» текстиля, контролирующего потоотделение33. Способы можно перечислять почти бесконечно.
Но сколько и какие именно данные нам нужны? Один из ответов можно найти в рассказе аргентинского эссеиста Хорхе Луиса Борхеса, процитированном выше. В этом кратчайшем из рассказов Борхес рисует в воображении время, когда наука картографии стала настолько точной, что достаточной считалась только карта того же масштаба, что и сама империя. Пусть в эпоху интернета подробнейшие карты и могут уместиться на экране смартфона, действительно ли нам необходимо дублировать на них каждый камешек в асфальтовом покрытии, чтобы не разбиться на дороге?
В какой степени науке необходимо представить человеческое тело, чтобы понять его? Когда дело доходит до создания виртуального человека, должны ли мы, как Суарес Миранда, фиксировать все 7 000 000 000 000 000 000 000 000 000 (7 октиллионов) атомов в теле, не говоря уже обо всех деталях еще большего скопления простых частиц – вращающихся протонов, нейтронов и электронов, – которые составляют каждый из атомов? Решая, сколько данных нам нужно, чтобы сделать первый шаг к созданию цифрового двойника, сможем ли мы не утонуть в данных, избежать проклятия гильдии картографов?
Есть и другие вопросы, которые следует рассмотреть. Мы ищем данные, которые можно измерить где угодно, с использованием одного оборудования, в одинаковых условиях и по одним и тем же протоколам. Даже разные люди, использующие разное оборудование, должны прийти к схожим результатам в одинаковых условиях34. Нам необходимо собирать эти данные эффективным и современным способом: науку всегда подстегивает разработка новых инструментов, таких как микроскопы, секвенаторы и сканеры. Существуют также проблемы с курированием, хранением и защитой данных. И, конечно же, возникают практические вопросы по обработке всех этих данных: даже самый мощный компьютер, который появится в ближайшие десятилетия, не сможет смоделировать молекулярный уровень человеческого тела, который, по оценкам, состоит из примерно от 20 000 000 000 000 000 000 000 000 до 1 000 000 000 000 000 000 000 000 000 молекул.
Мерило себя
Интуитивно кажется разумным предположить, что, чтобы создать виртуальную версию, нам нужно знать о вас все, что только можно. Но измерить состояние всех молекулярных ингредиентов (не говоря уже обо всех составляющих вас атомах) – непростая задача. Сколько же данных будет достаточно? Хватит ли знания, что ваше тело состоит примерно из 20 000 генов? Или что в нем трудится замечательный коллектив из 37,2 триллиона клеток35? Или что ваш мозг весит 3 фунта и требует около 20 Вт энергии? Или что молекулы в вашем теле представляют собой различные смеси из примерно 60 атомов разных видов (элементов), включая 25 г магния, содержащегося в костях и мышцах, 1,6 мг кобальта, содержащегося в витамине B12, 4 мг селена и 96 г хлора36? Или что нужно около 1011 бит (100 000 000 000 бит), чтобы выразить сканирование вашего тела длиной до 1 мм? Или что понадобится 1032 бит (единица, за которой следуют 32 нуля) информации, чтобы описать ваше тело с атомарным разрешением?
Данные не равнозначны. Особенно показательные данные включают «эмерджентные» свойства, которые отражают коллективное поведение большого числа микроскопических составляющих, где сумма качественно отличается от поведения частей. Свою первую книгу мы начали с австрийского физика Людвига Больцмана (1844–1906), продемонстрировавшего, как свойства жидкостей и газов возникают из поведения составляющих их молекул, что помогло открыть область, которую сегодня называют статистической механикой. Питер Слоот, который работает с Питером в Амстердамском университете, описывает эмерджентность с точки зрения взаимодействующих элементов, адаптирующихся к среде, которую сами помогают создать37. Пол Нерс определяет эмерджентность как взаимодополняемость: высокие уровни биологического описания (например, уровень клетки) ограничивают события, которые происходят на низких уровнях (например, среди молекул жизни). «В результате, – сказал он нам, – вы никогда не сможете построить жизнь просто снизу вверх»38.
Из множества примеров в биологии, где целое больше суммы частей, наиболее яркими являются сама жизнь и сознание. Хотя мозг может быть счастливым, его нейроны не ограничены эмоциями. Точно так же бактерия жива, а составляющие ее молекулы – нет. Даже если бы мы знали все молекулярные детали организма, вплоть до последнего атома, мы не могли бы сказать, что это и есть рецепт живого существа.
Следствием эмерджентности является то, что переносить знание обо всем с одного уровня описания (октиллионы атомов, составляющих тело) на другой (например, одна клетка) – непрактично, не нужно и все равно недостаточно. И если бы мы попытались смоделировать движения сердца, начав с атомного уровня, мы бы обнаружили, что моделирование может занять целую вечность, даже с использованием самых мощных компьютеров. Нет смысла создавать идеальную – в редукционистском смысле – модель сердца вплоть до последнего атома, если одно виртуальное сердцебиение этой модели занимает тысячелетия.
Наука о сложности также говорит нам, что видеть каждую деталь не нужно39. Мы интуитивно знаем это, потому что медицина иногда концентрируется на элементарных вопросах, таких как уровень натрия или железа, но диагностика обычно фокусируется на высоких уровнях описания: от рентгена костей до артериального давления и частоты сердечных сокращений. Чтобы понять науку о человеке, нам нужно гораздо меньшее количество данных с низких (то есть наименьших) уровней, чем кажется. Более того, сосредоточив внимание на каждом листике, ветке и дереве, мы легко можем упустить лес.
Хотя наши знания о том, как работает человеческое тело, зависят от понимания его составных частей, очень важно осознавать, как все эти части работают вместе, если мы хотим ухватить его эмерджентные свойства. Даже если мы поймем роль ДНК в клетке (в настоящее время мы понимаем лишь небольшую часть ее функций) и функцию этой клетки в органе, это не означает, что мы сможем выяснить физиологию организма, поскольку на каждую клетку влияет активность клеток других тканей, органов и систем органов. Когда речь идет о патогенах, таких как вирусы, нам также необходимо понимать их перемещение между организмами, как при пандемии. А еще есть способы, которыми организмы взаимодействуют друг с другом, будь то вирус в хозяине, человек в деревне или избирательный округ в обществе, которое само по себе является огромным субъектом. Роджер Хайфилд является соавтором целой книги Supercooperators о том, как и почему люди являются видом, наиболее склонным к сотрудничеству40.
И даже если не брать это в расчет, на все уровни организации влияют окружающая среда, диета и образ жизни: воздействие солнечного света, стресс, фастфуд и физические упражнения. С самых первых дней моделирования физиологии человека мы обнаружили доказательства «нисходящей причинности», то есть того, как воздействие на высокие уровни организации тела может изменить способ использования генов в клетках. Мы можем быть носителями генов, повышающих риск развития диабета 2-го типа, но если мы соблюдаем здоровую диету и достаточно занимаемся спортом, болезнь может не развиться. Точно так же кто-то может нести гены, которые снижают риск развития рака легких, но постоянное курение все равно имеет катастрофические последствия. Биология человека – это больше чем просто сумма природы и воспитания.
От порядка к хаосу
Появление новых организованных атрибутов и структур из взаимодействующей системы клеток, тканей и органов в данной среде – светлая сторона теории сложности. Однако существует и темная сторона в форме так называемого динамического хаоса. Он накладывает еще одно ограничение на то, в какой степени мы можем превратить данные о человеческом теле в его понимание.
Динамический хаос – не то же самое, что случайность. На самом деле это тонкая форма порядка, освобожденная от оков периодичности и предсказуемости. Хаос может возникнуть из обманчиво простых на вид уравнений, содержащих ключевой ингредиент – нелинейность, когда изменение результата не пропорционально изменению входных данных. Примеров нелинейности предостаточно: от скачка температуры, вызывающего отключение котла, до воя, возникающего, когда микрофон подносится слишком близко к источнику звука. Нелинейность может привести к хаосу, когда точное поведение невозможно предсказать в долгосрочной перспективе.
Хаос является обычным явлением: от непредсказуемых колебаний маятника до капризов погоды41. Хаос таится и внутри тела. Проблема динамического хаоса заключается в том, что, если вы не вводите данные с бесконечной точностью (что невозможно), эти сложные нелинейные взаимодействия делают невозможными точные долгосрочные прогнозы. Таким образом, хотя вам не обязательно знать все о теле, чтобы его смоделировать, когда нам придется формулировать прогнозы с точки зрения вероятностей, небольшие изменения в данных могут привести к большим, непредсказуемым результатам.
Инструментальные данные
Чтобы определить, в какой степени мы хотим охватить всю сложность человеческого тела и сделать первый шаг к виртуальному двойнику, нам нужно думать о данных как об инструменте, а не о репрезентации. По той же причине карты различаются в деталях в зависимости от цели их применения: путешественнику необходимо видеть каждое поле и тропинку, а пилоту самолета нужна карта местности, аэропортов, воздушных пространств и маяков. Точно так же уровень детализации, который нам необходим, чтобы сделать первый шаг к созданию виртуального человека, зависит от того, какие задачи мы хотим решить.
Простого измерения, например, температуры может быть достаточно, чтобы выяснить, подхватил ли ребенок инфекцию. Но у пожилых людей нам могут потребоваться более подробные данные о том, как они реагируют на инфекцию, чтобы понять, что происходит. Например, когда речь идет о серьезной инфекции мочевыводящих путей, первым признаком проблемы может быть спутанность сознания, а не повышение температуры. И если нужно понять, какая инфекция вызывает проблему, требуются дополнительные данные, такие как генетический состав инфицирующего организма.
Данные действительно полезны, когда основаны на научном методе – самом мощном способе обеспечить рациональное понимание того, как работает организм. Он опирается на теорию; в противном случае наука была бы не более чем каталогизацией воспроизводимых наблюдений. Как мы упоминали во введении, уравнения типичной теории представляют работу природы более экономично, чем огромные хранилища необработанных данных. Теория помогает нам раскрыть принципы и законы, которые объясняют, как и почему тело работает именно так. Нам еще предстоит сказать об этом в следующей главе, где мы обсудим второй шаг к виртуальному человеку. Однако прежде всего необходимо найти способы сбора данных из тела.
Краткая история анатомии
«Так многое в прогрессе зависит от взаимодействия методов, открытий и новых идей, вероятно, именно в таком нисходящем порядке». Когда лауреат Нобелевской премии Сидней Бреннер сделал это замечание в марте 1980 г. на симпозиуме, организованном Институтом Фридриха Мишера в Базеле, Швейцария, он с нетерпением ждал следующего десятилетия в биологии42. Как предсказывал Бреннер, развитие виртуального человека было обусловлено новыми технологиями и продолжает зависеть от большего количества новых данных. Когда дело доходит до структур тела, целый ряд методов раскрывает беспрецедентные детали.

Рисунок 4. Портрет Везалия из его книги De Humani Corporis Fabrica (1543) (автор Ян ван Калькар)
Перечислять их можно бесконечно, за века появилось множество замечательных способов рассмотрения тела. Одним из примеров является публикация в 1543 г. De Humani Corporis Fabrica («О строении человеческого тела») Андреаса Везалия – выдающегося 700-страничного труда (1514–1564), в котором представлено более 200 гравюр на дереве, основанных на вскрытиях человеческого тела.
Чтобы расширить знания о диссекции и традиционной анатомии, был разработан широкий спектр методов. «Микрография», первая важная работа по микроскопии, была опубликована в 1665 г. В этом новаторском научном бестселлере Роберт Гук (1635–1703) раскрыл микроскопическую структуру пробки. Он показал стенки, окружающие пустые пространства, и назвал эти структуры клетками. Сегодня с помощью технологий микроскопии можно рассмотреть детали клеток вплоть до атомного масштаба43.
Нам больше не нужно изучать тело только с помощью видимого света. В 1895 г. немецкий физик Вильгельм Рентген (1845–1923) открыл невидимый вид лучей, названный рентгеновским излучением или рентгеновскими лучами. В то Рождество он написал 10-страничную статью, в которой описал, как рентгеновские лучи могут сделать кости видимыми. Эти раскрывающие лучи также позволят изучить молекулярный механизм клеток с помощью метода, называемого дифракцией рентгеновских лучей. Сегодня существует множество других методов, позволяющих заглянуть внутрь живого тела: от терагерцового излучения до ультразвука. Мы даже можем использовать антивещество в виде позитронов (антиэлектронов) для изучения метаболизма.
В организме есть электрическая система, и о ней тоже нам нужны данные. В то время как по проводам электричество движется со скоростью около 1 мм/с (хотя связанная с ним электромагнитная волна распространяется примерно со скоростью света, 300 000 км/с), сигналы в нашем теле движутся со скоростью 0,08 км/с, или около 290 км/ч. Внутри нас электричество переносится более крупными и сложными ионами, а не проворными электронами (заряженными субатомными частицами), которые питают наши дома.
Исследования того, как импульсы распространяются по нервам, восходят к разработке метода «зажима напряжения» в 1930-х и 1940-х гг. биофизиком Кеннетом Коулом (1900–1984) из США вместе с Аланом Ходжкином (1914–1998) и Эндрю Хаксли (1917–2012) из Великобритании, которые нашли способ проводить измерения, продевая электроды в гигантский аксон – нервную клетку – кальмара.
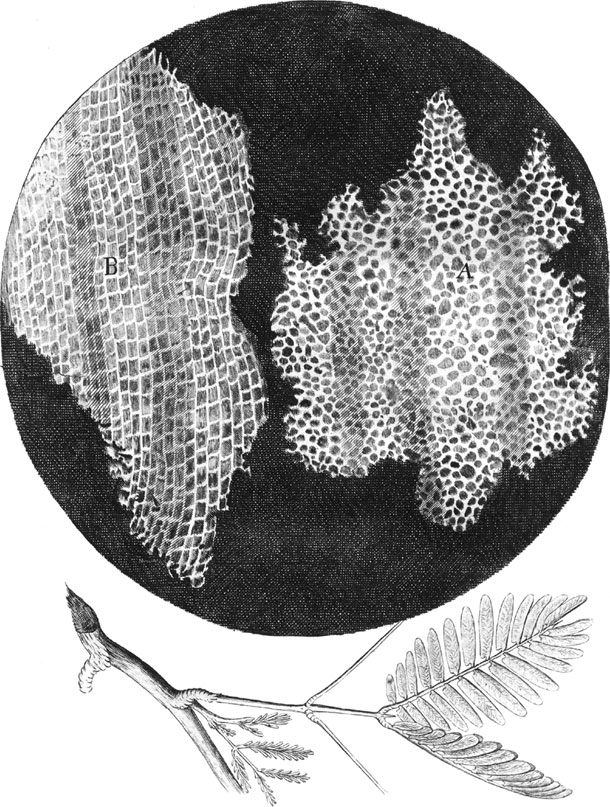
Рисунок 5. Клеточная структура пробки, представленная Робертом Гуком, «Микрография» (1665)
Еще лучшее понимание «проводки» тела стало возможным благодаря технике, которая позволяет регистрировать мизерные электрические токи силой около пикоампера (миллионная миллионной доли ампера), которые проходят через одиночный ионный канал, одну молекулу или комплекс молекул, позволяющий ионам проникать через мембрану клетки. В 1976 г. немецкие клеточные физиологи Эрвин Неер и Берт Закман сообщили, как это сделать с помощью крошечного, но простого устройства, называемого локально-изолирующим электродом.
Они использовали кончик чрезвычайно тонкой стеклянной пипетки, чтобы прикоснуться к крошечному участку внешней мембраны клетки, который, по счастливой случайности, содержал единственный ионный канал. Небольшое всасывание обеспечивало герметичное уплотнение, так что ионы могли течь только из канала в пипетку. Используя чувствительный электрод, они смогли зафиксировать крошечные изменения тока, когда ионы проходили через зажатый канал. За это замечательное открытие в 1991 г. Неер и Закман получили Нобелевскую премию.
Но данные, которые привлекли наибольшее внимание в последние годы, связаны с чтением генетического кода человека. За это мы можем поблагодарить британца Фредерика Сэнгера (1918–2013), одного из величайших новаторов в молекулярной биологии: «Из трех основных видов деятельности, связанных с научными исследованиями – мышлением, разговорами и действиями, я предпочитаю последний и, вероятно, именно он у меня лучше всего получается»44. Он был прав. Став первым, кто раскрыл структуру белка (это оказался инсулин), Сэнгер в середине 1970-х разработал методы секвенирования ДНК, за что во второй раз стал лауреатом Нобелевской премии.
Со времени новаторской работы Сэнгера стоимость секвенирования человеческого генома (генетического кода в ДНК человека) резко упала – с миллиардов долларов до сотен. Одной из причин является появление секвенирования «следующего поколения» – прорыва, который сравнивают с переходом от самолета братьев Райт к современному Боингу.
В 1997 г. химики Кембриджского университета Шанкар Баласубраманиан и Дэвид Кленерман начали разрабатывать свой метод, согласно которому образец ДНК делится на фрагменты, которые иммобилизуются на поверхности чипа и локально амплифицируются. Затем каждый фрагмент декодируется, вплоть до «буквы» генетического кода (нуклеотида – подробнее позже), с использованием флуоресцентно окрашенных букв, добавленных ферментом. Обнаружив цветные буквы, включенные в каждую позицию чипа, и повторив этот цикл сотни раз, можно прочитать последовательность каждого фрагмента ДНК45.

Рисунок 6. Метод локальной фиксации потенциала. Адаптировано из книги Александра Д. Рейеса «Прорывной метод, который стал жизненно важным для нейробиологии» (A Breakthrough Method that Became Vital to neuroscience). (Nature, 2019)
Еще одно достижение в области секвенирования нового поколения относится к 1970-м гг., когда Стив Хладки и Денис Хейдон из Кембриджа зафиксировали поток тока через одиночный ионный канал в искусственной мембране. Поскольку ДНК является заряженной молекулой, она также может пройти через этот открытый канал и при прохождении вызывает колебания тока, соответствующие генетической последовательности. Последующее развитие коммерческого «нанопорового секвенирования» компанией Oxford Nanopore Technologies (в частности, ее основателем Хэганом Бэйли) можно проследить до исследований 1980-х гг., когда впервые было обнаружено движение ДНК через поровые белки46.
Используя новую технологию секвенирования, можно считывать значительно более длинные участки ДНК, чем ранее, поэтому в 2021 г. международная группа из 30 учреждений – Консорциум Telomere-to-Telomere (T2T) – опубликовала первый «длинно читаемый» геном47. Это было важное открытие, поскольку исторический проект последовательностей человеческой ДНК, опубликованный в июне 2000 г., пропускал целых 15 % генома: более ранние технологии секвенирования параллельно считывали код миллионов фрагментов ДНК, каждый из которых был относительно небольшим и содержал до 300 букв кода. В результате они не могли справиться с повторяющимися участками кода ДНК, скрывающимися в геноме, особенно с центромерами – защемленными частями хромосом, которые играют ключевую роль в делении клеток. Сквозная последовательность 2021 г., основанная на длинном чтении от 10 000 до 100 000 букв, выявила 115 новых генов, кодирующих белки, и, вероятно, содержит множество областей, которые играют роль в регуляции генов и других функциях.

Рисунок 7. Как ДНК, проходящая через канал нанопоры, генерирует сигнал (дизайн – Ёритака Харазоно. TogoTV. cc BY 4.0)
Код жизни
Два десятилетия назад, когда на горизонте появились детали всего генетического кода человека, вопрос о том, какие данные необходимы для определения человеческого существа, имел соблазнительно простой ответ. Детали сложной структуры тела, казалось, заключены в ДНК – самом известном биологическом носителе информации. В начале этого столетия общественность была убеждена, что понимание кода ознаменует эру персонализированной медицины.
Биологи знали, что человеческий геном является чрезвычайно важным ресурсом, и в этом не может быть никаких сомнений. Копия находится в каждой из ста триллионов ваших клеток (за исключением красных кровяных клеток – они разрушают свою ДНК, чтобы переносить как можно больше кислорода, оставаясь при этом достаточно маленькими, чтобы проходить через капилляры). Подобно томам вашей «библиотеки», ДНК упакована в коробки, известные как хромосомы. Обычно в клетках человека имеется 46 хромосом. Если взять самую большую хромосому (вторую), то ДНК, содержащаяся в ней, в развернутом виде будет иметь размер более 8 сантиметров48.
Используя рентгеновские лучи для изучения скрученной спиральной ДНК в каждом из этих пучков, можно понять, как она передает данные. Внутри двойной спирали ДНК находится лестница закодированной информации, где каждая «ступенька» состоит из двух химических единиц, называемых нуклеотидными основаниями. Эти единицы бывают четырех типов: аденин А, тимин Т, гуанин G и цитозин С. Из-за своей формы и химических свойств основания всегда образуют пары внутри ступени одинаковым образом: C соединяется только с G, а A соединяется только с T. В наших 46 хромосомах шесть миллиардов таких букв.
Вот почему двойная спираль также хранит секрет того, как клетки могут передавать свои инструкции после деления: если разделить нити двойной спирали, ступеньки лестницы разделятся на взаимодополняющие основания. Каждая полученная цепь может действовать как шаблон для копирования исходной партнерской цепи и сохранять информацию о том, как создавать белки, которые строят тело и управляют им (с помощью множества механизмов коррекции клеточных ошибок).
Порядок, в котором появляются основания, описывает код жизни аналогично буквам в этом предложении, только сообщения, которые они несут, содержат инструкции по созданию белка – одного из строительных блоков клеток – посредством вмешательства родственной генетической молекулы, называемой РНК. Информация в генах записана в трехбуквенном коде, причем тройка букв ДНК – кодон – отвечает за определенную аминокислоту, которая при соединении с цепочкой других аминокислот сворачивается в белок – один из блоков, которые строят ваши клетки и управляют ими.
Несмотря на то, что существует всего 20 различных аминокислот, для создания вас клетки вашего тела используют огромное количество комбинаций из таких разных белков, как гемоглобин (красный пигмент, который переносит кислород в вашей крови), инсулин (сигнальная молекула, которая сыграла главную роль в Нобелевской премии Сэнгера), или фермент АТФ-синтаза (преобразующая энергию молекулярная машина, примерно в 200 000 раз меньше булавочной головки, вращающаяся со скоростью 60 раз в секунду, производя энергетическую валюту нашего тела – молекулу под названием АТФ).
Всего, как говорилось ранее, в организме насчитывается около 37,2 триллиона клеток, и, хотя они (за парой исключений, таких как эритроциты по ранее упомянутым причинам) содержат всю информацию ДНК человека, каждый вид клетки во взрослом организме зависит от использования только определенного подмножества генов в геноме. Таким образом, клетки могут специализироваться на одном типе: от нервных и мышечных до клеток, населяющих органы, например мозг и сердце. Неудивительно, что многие думают, будто человеческий геном содержит все ответы, когда дело касается биологии человека.
За гранью ДНК
Первым человеком, который узнал о своих собственных генетических данных – и их ограничениях – был пионер геномики и предприниматель Крейг Вентер49, который в 2000 г. возглавил частную попытку создать первый черновой вариант последовательности генома человека. 4 сентября 2007 г. группа под руководством Сэма Леви из Института Дж. Крейга Вентера в Роквилле, штат Мэриленд, завершила чтение генетического кода Вентера, что ознаменовало публикацию первого полного (шесть миллиардов букв) генома отдельного человека50.
Роджер редактировал автобиографию Вентера «Расшифрованная жизнь»51 и помнит, что даже Вентер был удивлен тем, как мало его геном смог раскрыть. В то время никто не знал, как правильно читать геномы. Это одна из причин, почему в более позднем проекте под названием Human Longevity Inc. (HLI) Вентер, как и Лерой Худ и другие, не только собрал геномную информацию, но и связал ее с фенотипами: анатомией, физиологией и поведением пациентов, от когнитивных онлайн-тестов до эхокардиограммы и анализа походки52.
С помощью HLI скрининг выявил широкий набор дополнительных рисков возрастных хронических заболеваний, связанных с преждевременной смертностью, и улучшил интерпретацию полногеномного анализа53. «В клинике мы каждый день спасаем жизнь по крайней мере одному человеку, обнаруживая серьезную опухоль, о которой он даже не подозревал», – сказал нам Вентер, приводя несколько убедительных, но анекдотических примеров. В его случае, когда обычные методы объявили его свободным от рака, скрининг HLI выявил рак простаты, который начал распространяться. У нобелевского лауреата Хэма Смита, давнего сотрудника Вентера, обнаружили серьезную опухоль легких. Эти своевременные диагнозы были поставлены не на основе генетики, а с помощью мощного МРТ-сканера мощностью 3 Тесла (примерно в 60 000 раз сильнее, чем магнитное поле Земли) с расширенным анализом изображений. Вентер рассказал нам, что в этом сканере «опухоли загораются, как лампочки»54.
Фенотип (то есть наблюдаемые черты и характеристики тела, от цвета глаз до рака) очень далек от генотипа или генетического рецепта тела. Думать, что единственный вид данных, обнаруженный в геноме, может раскрыть суть человека, – все равно, что пытаться определить внешний вид, вкус и ощущение торта по рецепту. Некоторые вещи – фрукты и смородина – сразу понятны, но многие другие гораздо менее очевидны.
Хотя секвенирование человеческого генома ознаменовало конец почти столетних усилий по поиску генов, кодирующих белки, оно подчеркнуло, как мало мы знаем о регуляторных элементах, не кодирующих белки, но составляющих геном55. Из трех миллиардов букв ДНК в геноме человека только около 2 % кодируют белки, которые строят и поддерживают наше тело. Хотя последние два десятилетия стали золотым веком открытия генов, около 20 % человеческих генов с жизненно важными функциями остаются окутанными тайной (согласно исследованию неизвестного генома, проведенному Шоном Манро из Лаборатории молекулярной биологии в Кембридже и Мэтью Фриманом из Школы патологии Данна Оксфордского университета)56. Нам предстоит еще много работы, помимо понимания генов. Когда-то интроны были среди огромных участков человеческой ДНК (около 98 %), отбрасываемых, как бессмысленный мусор. Теперь мы знаем, что эти некодирующие области генома содержат важные регуляторные элементы, которые определяют, как контролируется экспрессия генов, но всего мы по-прежнему не понимаем57.
Также огромный всплеск интереса к использованию генов в организме произошел в области, называемой эпигенетикой. Деление клеток на разные типы связано с особенностями экспрессии генов, а не с изменениями в самой ДНК. Питательная среда начинается с хромосомы – пучка ДНК в наших клетках. Хромосомы четко организованы, как и белки, которые с ними взаимодействуют, и эта организация, по-видимому, важна для использования генов58. Паттерны использования генов могут быть основаны на химических модификациях ДНК (например, украсив ген химическими фрагментами, называемыми метильными группами, вы его выключите), а также на гистонах – крошечных белках, которые прикрепляются к ДНК, как бусины на ожерелье, и играют роль в упаковке ДНК и регулировании способа активации генов. В результате связь между генотипом и фенотипом не является прямой.
От ДНК к белку
Истории ДНК могут быть запутанными. Традиционные генетические исследования искали вариант ДНК, связанный с определенным заболеванием. Иногда все просто: мутации в гене, ответственном за фактор свертывания крови, вызывают наследственное заболевание – гемофилию, которую иногда называют королевской болезнью, поскольку она широко распространена в европейских королевских семьях.
Однако зачастую эти корреляции рассказывают сложную историю. Когда дело доходит до распространенных заболеваний головного мозга, таких как шизофрения и болезнь Альцгеймера, огромный объем информации поступает в результате полногеномного поиска ассоциаций (GWAS), в котором исследователи стремятся сравнить генетические последовательности тысяч людей с определенным признаком. Хорошей новостью является то, что сотни геномных регионов могут быть связаны с риском развития заболевания головного мозга у человека. Но иногда это триумф данных над пониманием. Объяснение того, почему спектр генетических вариантов влияет на здоровье, остается сложной задачей59. Даже если мы действительно связываем варианты с заболеванием, исследования диабета, например, показали, что на генетику приходится только около 10 % различий, наблюдаемых при заболевании, а остальное зависит от образа жизни и питания60.
Сопоставление данных о генотипе с фенотипом осложняется тем фактом, что количество наших генов значительно превосходит количество белков. Гены можно перетасовать и использовать разными способами. Способность каждого гена кодировать множество белков обусловлена процессом, известным как альтернативный сплайсинг, при котором биты кода, называемые интронами, соединяются, а оставшиеся части гена, известные как экзоны, при создании белка могут включаться или бездействовать. Теоретически из одного гена можно получить до 100 белков61.
Даже при кодировании участков ДНК не существует прямого соответствия между линейным кодом ДНК и трехмерной формой белков в организме, что имеет решающее значение для их работы – например, для ускорения клеточной химической реакции. Для белка, содержащего всего 100 аминокислот, число альтернативных структур, которые он может принять в водной среде клетки, колеблется где-то между 2100 и 10100 возможных конформаций (форм). Изучение каждой из них заняло бы вечность, но этот одномерный код приобретает правильную трехмерную форму (что имеет решающее значение для его работы) с помощью различных видов поддержки.
Одним из способов принятия правильной формы является непрерывное движение молекул в клетках, вызванное тепловой энергией. Многие из жизненно важных компонентов живой клетки достаточно малы, чтобы подвергаться постоянным ударам моря окружающих молекул (броуновское движение), что может помочь белку принять наиболее стабильную форму, даже если количество возможных стабильных конфигураций варьируется от миллионов до триллионов62. Кроме того, существует множество механизмов точной настройки того, как организм интерпретирует генетические данные и превращает их в белки.
Некоторые из способов, помогающие белкам сворачиваться в наших клетках, можно найти в замечательной молекулярной машине, называемой рибосомой, состоящей из примерно полумиллиона атомов и размером около одной миллионной дюйма в поперечнике. Эта машина лежит в центре двух эпох жизни на Земле: одной – знакомой, а другой – окутанной тайной. Первая состоит из сегодняшних живых существ, основанных на ДНК, а вторая отражает самые первые существа, которые делились и, как предполагается, основывались на РНК – тонком, но гибком виде генетического материала, который не только хранит информацию, но, в отличие от ДНК, также может катализировать химические реакции. Действительно, рибосома – это рибозим, фермент, состоящий из РНК, свернутой в сложную структуру.
Загляните глубоко внутрь рибосомы, как это сделали структурные биологи, и вы увидите древнее ядро, которое превращало инструкции в белки для построения живых существ на протяжении большей части четырех миллиардов лет. Там вокруг центрального механизма РНК, чтобы отточить его работу, развилась белковая оболочка, различная в зависимости от существа: например, наши рибосомы почти в два раза больше, чем у насекомых, которые нас заражают.
Для работы рибосомы необходимы различные ингредиенты: во-первых, молекула матричной РНК, которая несет в себе инструкции по созданию белка из ДНК. Чтобы превратить этот код в белок, рибосома использует второй тип РНК – транспортную, которая несет в себе строительные блоки белков, называемые аминокислотами.
Сейчас мы знаем атомные детали того, как рибосома превращает данные ДНК в плоть и кости, благодаря получившим Нобелевскую премию рентгеновским исследованиям Венки Рамакришнана в Великобритании, Ады Йонат в Израиле и Томаса Стейца в США. Они обнаружили, что рибосома состоит из трех разных молекул РНК и более 50 различных белков, разделенных на два компонента (60S/40S в наших клетках и 50S/30S у бактерий). Один из них – «мозг», считывающий генетический код, а другой – большое «сердце», производящее белок (рис. 8). Они расходятся и объединяются по мере того, как молекулярные связи создаются и разрушаются, производя белки, которые строят тело и управляют им.

Рисунок 8. Рибосома (Венки Рамакришнан, Mrc LMB)
Подобные детальные исследования показывают, что перевод генетических данных в белок – сложное явление. Этот процесс, известный как экспрессия генов, начинается с того, что информация, содержащаяся в генах (ДНК), превращается в информационную РНК (которая также состоит из четырех «букв» – химических веществ, называемых основаниями – на основе инструкций в ДНК, хотя в РНК основание урацил U заменяет тимин Т). Рибосома, как перфолента, считывает по три буквы информационной РНК и сопоставляет ее с тремя буквами транспортной РНК, выстраивая аминокислоты, которые они несут, в правильном порядке, а затем сшивает их вместе. В целом рибосома пропускает через свое ядро насыщенные аминокислотами РНК со скоростью 15 раз в секунду, связывая их вместе в белки63.
Однако критически важно то, что в итоговой конфигурации, принимаемой белком, ключевую роль снова играет окружающая среда. Гуннар фон Хейне из Стокгольмского университета рассказал нам, как рибосома помогает придавать белкам форму. Этот процесс, известный как котрансляционное сворачивание, начинается в выходном туннеле этой великой молекулярной машины, в которой есть укромные уголки и щели64. Притяжения и изменения обеспечиваются стыковочными участками в выходном туннеле, которые прикрепляются к определенным частям зарождающихся белков, в зависимости от последовательности аминокислот65. Существуют также белки-шапероны, которые помогают многим белкам принимать форму. Несколько разных шаперонов скрываются в устье выходного туннеля, остальные – за пределами рибосомы. Различные механизмы контроля качества отторгают и разрушают неправильно свернутые белки, прежде чем они достигнут гудящего химического хаоса клетки.
В целом от одномерного кода к трехмерному белковому строительному блоку тела нас ведет поразительно сложная серия шагов. Тем не менее во время своей речи на вручении Нобелевской премии по химии 1972 г. Кристиан Анфинсен сделал смелое заявление, постулировав, что аминокислотная последовательность белка должна полностью определять его структуру в растворе. Это предположение стало грандиозным вызовом биологии: можем ли мы определить трехмерную структуру белка по его одномерной аминокислотной последовательности?
Масштаб этой проблемы обрисовал Сайрус Левинталь, американский молекулярный биолог, который был пионером в компьютерном графическом отображении белковых структур. Он отметил, что для определения вероятных конфигураций типичного белка путем грубого расчета (то есть путем тестирования каждой возможной формы, которую он может принять) потребуется больше времени, чем возраст известной Вселенной. Левинталь подсчитал, что существует 10300 возможных конформаций типичного белка, и почти парадоксально, что клетка может «разработать» функциональную версию гораздо быстрее, чем компьютер. Однако в четвертой главе мы описываем, как ИИ догнал клеточную реальность. Когда дело доходит до виртуального человека, этот подвиг может дать много подсказок (например, когда белки принимают неправильную форму, вызывающую болезнь) и помочь провести виртуальные испытания лекарств для поиска возможных методов лечения.
Колоссальный объем данных
Мы живем в эпоху того, что некоторые называют большими данными. Однако, когда дело касается медицины и биологии, большие данные на самом деле крошечны по сравнению со сложностью клетки, ткани или органа. Более того, у живых существ все эти данные постоянно меняются. Специалисты по данным любят говорить о «трех V»: объем (volume) – количество данных; разнообразие (variety) – сложность данных и источников, из которых они собираются; скорость (velocity) – скорость потока данных и информации. Сегодня скорость, разнообразие и объем данных кажутся ошеломляющими, хотя нам еще очень далеко до того, чтобы охватить всю сложность человеческого тела.
Другие говорят о достоверности (veracity) данных, которая тоже меняется. Большинство традиционных данных являются структурированными, то есть достаточно аккуратными, чтобы их можно было напрямую вставлять в электронные таблицы и базы данных. Представьте себе лабораторный блокнот, в котором в одном столбце указана одна величина, скажем, цвет реагентов в пробирке, а в другом – pH или число потомков в популяции кроликов, выстроенное по времени.
Когда дело доходит до создания виртуального двойника, существуют всевозможные структурированные наборы данных о пациентах, которые собираются регулярно в виде результатов замера температуры, анализов крови и мочи. Генетические данные становятся все более обширными, поскольку стоимость секвенирования нашей ДНК резко упала. На молекулярном уровне существует геометрическая информация о форме участков белков, где взаимодействуют другие молекулы, а также скалярные и векторные поля, используемые математиками и учеными для демонстрации изменяющихся величин – например, концентрации биохимического вещества в клетке. С помощью протеомики можно получить информацию о белках, а с помощью метаболомики – о метаболизме. Несколько рождественских праздников назад Роджер самоотверженно работал с командой Имперского колледжа Лондона над изучением метаболического воздействия похмелья66. Эти страдания, по-видимому, связаны с необычным профилем сахароподобных молекул и спиртов – полиолов, которые играют роль в обезвоживании67.
Но теперь мы вступили в эпоху неструктурированных данных, поскольку Интернет с помощью микрочипа оцифровывает все и вся, от твитов и СМС до сообщений в социальных сетях и загрузок на видеохостингах. По всему миру данные вытекают из датчиков, мобильных телефонов, приложений и вообще всего, что только можно себе представить, поскольку чипы встраиваются в обычные предметы домашнего обихода, от принтеров до холодильников, образуя так называемый интернет вещей.
Смартфоны и другие беспроводные устройства все чаще будут использоваться для сбора данных о пациентах – например, о движении, характере активности, артериальном давлении, частоте сердечных сокращений, исходящих и входящих звонках, использовании клавиатуры и обработке естественного языка – для цифрового фенотипирования, которое, в свою очередь, может использоваться для мониторинга биполярного расстройства, выявления проблем с употреблением алкоголя или распознавания дистресса68. Хотя диагноз психического здоровья когда-то был чисто субъективным, сегодня его можно сделать объективным с помощью огромного количества личных данных об активности и манере речи, тоне и дыхании – от смеха до вздохов.
В долгосрочной перспективе, по словам нашей коллеги из UCL Андреа Таунсенд-Николсон, точные и структурированные данные медицинского сообщества будут откалиброваны таким образом, чтобы сравнивать разных людей, в то время как мы будем использовать неструктурированные данные и «журналы жизни» со смартфонов и других устройств для тонкой настройки внешнего вида и поведения виртуального тебя.

Рисунок 9. Подробная анатомическая модель высокого разрешения, созданная на основе данных магнитно-резонансной томографии (IT’IS Foundation)
Целостность данных
Когда цифровые двойники будут созданы, каждый из них станет символом симбиотических отношений между человеком и его виртуальным собой, питающих друг друга данными и идеями. Возникнут практические вопросы, многие из которых уже нам знакомы. Некоторые ученые приходятся данным ненадежными хранителями, хотя все больше им поклоняются. Исследования, появляющиеся в журналах, ограничиваются выводами или резюме ключевых результатов, или же в них преобладают экперименты, которые дали обнадеживающие результаты, а остальные спокойно игнорируются и остаются неопубликованными. Необработанные данные, включая отрицательные данные неудачных экспериментов, часто опускаются и теряются для научного сообщества, а также для будущих исследователей. К счастью, сейчас ситуация начинает меняться.
Некоторые опасаются, что данные будут потеряны для будущих поколений из-за использования эфемерных носителей записи, устройств хранения данных, которые скоро устареют, и программного обеспечения, разработанного компаниями, чьи бизнес-модели зависят от запланированного устаревания и обязательных обновлений. Рассматривается множество решений: от публичных архивов до использования носителя информации, существующего уже миллиарды лет: один грамм ДНК способен хранить 215 петабайт (215 миллионов гигабайт), поэтому контейнер весом и размером примерно с пару пикапов в теории мог бы хранить все данные, когда-либо записанные человечеством69.
Действовать нужно последовательно, создавая уверенность, что разные ученые и инженеры в разных лабораториях смогут измерять одни и те же вещи, использовать один и тот же жаргон и сообщать о своих открытиях таким образом, чтобы их могли интерпретировать все, гарантируя воспроизводимость науки. Стоит попросить у исследователя материалы, и нередко с другой стороны ждут всевозможные проволочки, молчание или даже отказ. Иногда у них просто нет времени, денег, возможностей или желания (например, если необходимо менять форматы программного обеспечения). В каких-то случаях мешают эго, соперничество и эмоции – да, даже в научных дисциплинах, якобы основанных на объективности и разуме70.
Есть противоречия, которые необходимо понимать. Всегда существует компромисс между поощрением широкого использования данных и методов, с одной стороны, и коммерциализацией – с другой, и не в последнюю очередь это использование патентов для защиты идей и получения дохода. Более того, исследователи неохотно делятся своими новаторскими данными, если они рискуют стать не первыми, кто опубликует важные результаты и идеи, содержащиеся в этих данных. Не получив признания за понимание данных, которые они с таким трудом собирали, исследователи могут потерять деньги и признание, загнать в тупик свою карьеру и даже лишить себя Нобелевской премии.
Нам нужна открытость, чтобы данные свободно распространялись в хранилищах и банках данных, как государственных, так и коммерческих71. К счастью, существует множество ярких примеров обмена данными для публичного использования и общественного блага, например, US NCI Cancer Research Data Commons, Британский биобанк и инициатива GISAID по обмену данными обо всех вирусах гриппа и коронавирусе, вызывающем COVID-19. Хорошей новостью является то, что многие сейчас принимают так называемые принципы FAIR: данные должны быть находимыми (findable), доступными (accessible), совместимыми (interoperable) и воспроизводимыми (reproducible)72.
Существует множество острых вопросов, связанных с данными. Как люди могут получить доступ к своим медицинским данным? Владеют ли они ими сами или же это собственность больниц, в которых они хранятся? Хотят ли люди получить к ним доступ и управлять ими? Будут ли службы здравоохранения готовы их предоставлять? А как насчет объединения этих данных с данными других людей для проведения клинических и других исследований? А что с кибербезопасностью? Нам нужны принципы высокого уровня, а также руководящий орган, чтобы формировать все способы управления данными и обеспечивать надежность и доверие к управлению и использованию наших данных73.
От данных к мудрости
Первый шаг к созданию виртуального человека зависит от данных, но их одних недостаточно, чтобы понять связь между генетическим составом, окружающей средой и фенотипом человеческого тела. Нам необходимо понять сети, которые связывают все эти данные, прежде чем мы сможем начать замыкать цикл и превращать данные в прогностическую, количественную биологию. Прежде всего нам нужна теория.
Теории обладают объяснительной силой. Они придают смысл экспериментальным наблюдениям с точки зрения глубокого понимания того, как устроен мир. Они представляют работу природы экономичным образом, без объемных хранилищ необработанных и неинтерпретированных данных, и помогают нам раскрыть принципы и законы, которые объясняют, как и почему все обстоит именно так. Они также раскрывают эмерджентные свойства.
Такие законы и теории имеют математическую форму; поскольку это единственный способ, с помощью которого мы можем провести логически правильный анализ научных данных, которые сами по себе являются достоверными. Идея о том, что математика может отразить то, как устроен мир, и даже создать виртуального человека, восходит к Античности. Пифагор (570–495 гг. до н. э.) заявил, что «все есть число». Аристотель (384–322 гг. до н. э.) описал в своей «Метафизике», как пифагорейцы были настолько увлечены математикой, что «стали считать ее начала началами всего существующего».
Чем лучше мы понимаем ту или иную научную область и чем мощнее наши теории, тем меньше нам нужно полагаться на накопление массивов данных с той же усердностью, с какой филателист собирает коллекцию марок. Наши теории и модели, которые мы строим на их основе, представляют собой сжатый и гибкий способ представления нашего понимания природы. Окончательной проверкой наших теорий является не то, насколько хорошо они согласуются с экспериментами после их проведения, а то, насколько хорошо они могут предсказать результат до.
Это лучший научный метод, и некоторые из величайших теорий убедительно иллюстрируют, как превратить данные в идеи: среди них мы можем упомянуть открытие гравитационных волн, произошедшее через сто лет после того, как их предсказал Альберт Эйнштейн (1879–1955) – рябь в пространстве-времени, – которые генерируются жестокими космическими событиями, например столкновением двух черных дыр. Другим примером является открытие в 2012 г. бозона Хиггса, примерно через полвека после того, как теоретики Питер Хиггс, Роберт Браут и Франсуа Энглерт предположили, что эта фундаментальная частица связана с полем Хиггса – полем, которое придает массу другим фундаментальным частицам, таким как электроны.
Биологии тоже нужны большие идеи. Как выразился лауреат Нобелевской премии Пол Нерс: «Необходимо больше теории. Моими примерами в этом плане являются биологи-эволюционисты Билл Гамильтон и Джон Мейнард Смит, а также генетики Барбара Мак-Клинток и Фрэнсис Крик. Их статьи пронизаны богатой биологической интуицией, поэтому читать их одно удовольствие. Такое мышление ускорит переход от описания к знанию»74.
Теория придает смысл данным, а также тому, как они интерпретируются. Если мы нарушим законы термодинамики или сохранения массы, импульса и энергии, это не сулит ничего хорошего для достоверности виртуального человека. Прежде всего теория помогает выявить важные данные – те данные, которые, если их ввести в компьютерную модель, можно использовать для прогнозирования того, как тело будет себя вести. Это позволяет нам сосредоточиться на эмерждентных свойствах и избежать проклятия гильдии картографов Борхеса. Как только мы соберем достаточно данных о теле, вторым шагом на пути к виртуальному себе станет преобразование этой необработанной информации в математическое понимание. Нам необходимо создать математическую модель человеческого тела.
Глава 2
За бэконовскими муравьями, пауками и пчелами
«Те, кто занимался науками, были или эмпириками, или догматиками. Эмпирики, подобно муравью, только собирают и довольствуются собранным. Рационалисты, подобно паукам, производят ткань из самих себя. Пчела же избирает средний путь: она извлекает материал из садовых и полевых цветов, но располагает и изменяет его по своему умению».
Любопытство – пожалуй, самая фундаментальная из всех человеческих черт, и из всех тем, которые нас интересуют, немногие превосходят размышления о том, что будет дальше, особенно когда речь идет о нашей собственной судьбе. Конечная цель виртуального человека – дать врачам возможность заглянуть в будущее пациента, не типичного или «среднего», а конкретного, с индивидуальным багажом наследственности, воспитания и воздействия окружающей среды.
Наша замечательная способность предвосхищать будущее является вторым компонентом виртуального человека и восходит по крайней мере к VIII в. до н. э., когда вавилоняне превратили систематические наблюдения ночного неба в предсказания положения Солнца, Луны и известных планет77. Научная революция, последовавшая за эпохой Возрождения, превратила эту мощную и прозорливую смесь наблюдений и понимания в научный метод – возможно, величайшее достижение нашего вида. К XX в., когда ученые поняли, как механизировать большую часть математики с помощью компьютеров, у нас появились основные ингредиенты для создания виртуального человека, что и является темой этой главы.
Когда дело дошло до демонстрации совместной работы теории и эксперимента, философ и государственный деятель Фрэнсис Бэкон (1561–1626) был одним из первых, кто сформулировал научный метод. Мы были очарованы пророческими работами Бэкона несколько лет назад, когда вместе с нашим американским коллегой Эдом Догерти исследовали взаимосвязь между теорией, экспериментом, данными и искусственным интеллектом в статье для Philosophical Transactions of the Royal Society78, первого в мире и старейшего научного журнала, родившегося в 1665 г. в ходе научной революции.
Бэкон сравнил усилия своих коллег по пониманию мира, будь то работа органа или движение небес, с работой пауков и муравьев, где первые используют разум, а вторые полагаются на эксперимент. Важно отметить, что Бэкон осознавал – именно сочетание обоих подходов (метод пчел) необходимо для того, что мы сегодня называем наукой: подобно усердным маленьким насекомым, ученые-работники собирают данные экспериментов, чтобы разум мог преобразовать их в питательную информацию. В словах Бэкона можно увидеть схему того, как наука (по-прежнему) работает: разум направляет эксперимент, который прокладывает путь для новых рассуждений, а затем и новых экспериментов. Своей метафорой пчелы Бэкон отверг подходы муравья (зависящий от радикального эмпиризма (данные без разума)) и паука (опирающийся на рационализм (разум без данных)).
Пчелы Бэкона совершили множество громких открытий. Без кропотливых астрономических наблюдений датского дворянина Тихо Браге (1546–1601) немецкий астроном и математик Иоганн Кеплер (1571–1630) не определил бы, что планеты движутся по эллиптическим орбитам. Самое известное предсказание теории общей относительности – искривление звездного света массивным телом – было подтверждено измерениями, сделанными Артуром Эддингтоном (1882–1944) во время солнечного затмения 1919 г., превратив автора этой теории Альберта Эйнштейна в настоящую суперзвезду (1879–1955)79. В мае 1952 г., будучи аспирантом Королевского колледжа Лондона под руководством Розалинды Франклин (1920–1958), Рэй Гослинг (1926–2015) сделал фотографию 51 – рентгеновское дифракционное изображение ДНК. Без этой поразительной X-образной структуры рассеянных рентгеновских лучей Уотсон и Крик не смогли бы вывести структуру двойной спирали ДНК – волшебного ключа к разгадке генетики. Однако мы должны подчеркнуть, как это всегда делают историки науки, что реальность научного прогресса всегда сложнее, чем показывают рассказы о героях80.
Ученый разум
Когда современные ученые, особенно физики, говорят о подходе пауков Бэкона – «разуме», – они имеют в виду нечто большее, чем просто выражение нашего понимания рациональным, логическим способом или дедуктивный и индуктивный подходы к рассуждению, причем первый работает от общего к конкретному, а последний наоборот. Под рассуждением ученые подразумевают плетение паутины понимания в виде якобы железной математической логики, основанной на уравнениях.
Второй шаг на пути к виртуальному человеку – использовать одно или несколько уравнений, чтобы уловить детали того, как работает реальность, будь то электрическая активность нервной клетки, сила, создаваемая мышцей, или ритмы больного сердца. Что стоит за этими математическими формулами? Мы не знаем, и это не имеет значения. Значение имеет то, что эти математические выражения отражают грань реальности, описывая объективные наблюдения.
Говоря о силе тяжести, из-за которой наше кровяное давление в ногах выше, чем, например, в голове, можно заключить: определенно существует что-то, вызывающее градиент кровяного давления, но природа и сущность этого явления находятся за пределами нашего понимания. Фундаментальный принцип Hypotheses non fingo – «Я не выдвигаю гипотез» – резюмирован в одной из самых известных научных книг – «Математических началах натуральной философии» сэра Исаака Ньютона (1687)81.
Эта мощная идея продолжает жить. Однажды Роджер спросил Стивена Хокинга (1942–2018) о природе воображаемого времени. Хокинг ответил: «Все, что мы можем спросить, – это подтверждаются ли предсказания модели наблюдениями. Модели квантовой теории фундаментально используют мнимые числа и мнимое время. Эти модели подтверждаются многими наблюдениями. Таким образом, воображаемое время так же реально, как и все остальное в физике. Мне просто трудно его представить»82.
От исчисления к компьютерам
Мыслительная сила математики развивалась на протяжении тысячелетий, но через несколько десятилетий после смерти Бэкона ее способность описывать мир усилилась с изобретением исчисления – инструмента для изучения изменений, не в последнюю очередь происходящих внутри человеческого тела. Оно было независимо разработано в Англии Исааком Ньютоном (1643–1727), который представил его в своих «Началах», и в Германии Готфридом Вильгельмом Лейбницем (1646–1716). Эти значимые фигуры оказались втянутыми в Prioritätsstreit, «спор о приоритете», хотя элементы исчисления уже давно были замечены в Древней Греции, Египте, Индии и на Ближнем Востоке.
Исчисление состоит из двух частей: дифференциальное исчисление, которое фокусируется на скорости изменения, которую можно увидеть в изгибе кривой, например в милях в час; и интегральное исчисление, при котором накопление величин, таких как общее количество пройденных миль, рассчитывается путем определения площадей под кривыми или между ними (рис. 10). Полученные в результате ветви – дифференциальное и интегральное – объединяются в исчислении, которое решает обе задачи, разбивая их на очень маленькие (бесконечно малые) части. В то время как дифференциальное исчисление делит вещи на крошечные части и сообщает нам, как они изменяются от одного момента к другому, интегральное исчисление объединяет (интегрирует) эти части, чтобы выявить общий результат серии изменений. Первое дает производные, измеряющие мгновенное изменение в отдельный момент времени, а второе – интегралы, объединяющие бесконечное количество крошечных частей, которые складываются в целое, например бесконечный поток моментов. Таким образом, исчисление преобразует наш невыразимый мир потоков в точную математическую форму.
Математический анализ действительно имеет тенденцию вселять в людей определенный страх, но, как писал более века назад профессор физики Сильванус Томпсон (1851–1916) в книге Calculus Made Easy: «Дураки, которые пишут учебники по высшей математике – а они в большинстве своем умные дураки, – редко берут на себя труд показать, насколько простыми являются простые вычисления»83. Он пришел к выводу, что они предлагают ключи от «волшебной земли».
Например, когда дело доходит до второго шага к виртуальному двойнику, исчисление может раскрыть причину изменений в человеческом теле: от сердцебиения84 до колебаний метаболитов. Научный биограф и популяризатор Грэм Фармело сравнил математическую стенографию дифференциальных уравнений с поэзией: «Если «поэзия – это язык на орбите, как отметил нобелевский лауреат Шеймус Хини, то дифференциальные уравнения – это математический язык на орбите».
Разные классы уравнений требуют разных методов и разной степени усилий для их решения. В целом их можно разделить на линейные и нелинейные дифференциальные уравнения. Линейное многообразие напрямую связывает количества, например, когда X возрастает пропорционально Y (в степени 1). Количество апельсинов, которые вы можете купить в супермаркете, пропорционально тому, сколько денег вы на них тратите: удвоив деньги, вы купите вдвое больше фруктов. Нелинейные дифференциальные уравнения описывают более сложную зависимость, поэтому X возрастает пропорционально Y в другой степени, будь то 2, 1/2 или 100. В типичном (нелинейном) супермаркете, чем больше апельсинов вы покупаете, тем больше скидка. Нелинейность может привести и к неожиданным эффектам: имея достаточно апельсинов, можно открыть фабрику по производству мармелада.
В самом простом виде линейные уравнения решить легко (понадобятся только ручка и бумага), тогда как результаты нелинейных уравнений сложны. Последние – гораздо больше, чем просто кривая: они имеют решения, которые не являются идеальными, могут демонстрировать неоднородность и основываться на нескольких устойчивых состояниях вместо одного, так что верными будут более одного ответа. Эти трудные нелинейные уравнения, которые необходимо решать с помощью хитрой математики и компьютеров, также лучше всего отражают математику поворотов, волн, дуг и изгибов. Они созданы специально для человеческого тела.

Рисунок 10. Изображение, показывающее исчисление, производные и интегралы
Однако наш мозг жаждет простоты. Мы все хотим упростить себе жизнь. Исследования в области когнитивной психологии показывают, что человеческий разум недостаточно уважает нелинейные уравнения85. Распространенность нелинейных явлений не находит отражения в исследованиях и по удручающим практическим причинам: линейную математику решать гораздо проще. Это можно увидеть даже в самом слове «нелинейный», потому что исключение на самом деле является правилом. Польско-американский ученый Станислав Улам, с которым мы встретимся в следующей главе, однажды пошутил: «Это все равно, что называть зоологию изучением „животных, не являющихся слонами“»86.
Вездесущность нелинейности была открыта в 1889 г. французским эрудитом Анри Пуанкаре, которого его учитель прозвал un monstre de mathématiques87. Пуанкаре обнаружил, что стоит попытаться проанализировать движение всего лишь трех тел (Солнце, Луна и Земля), и точное решение не может быть найдено аналитическими методами «ручки и бумаги» (это называется «внутренне неинтегрируемая, нелинейная система»).
Пуанкаре открыл то, что мы сегодня называем динамическим хаосом: когда уравнения дают предсказуемые результаты – они детерминированы, – но чрезвычайно чувствительны к введенным в них числам. Без бесконечной точности существует предел того, насколько далеко можно предсказать будущую эволюцию хаотической системы. Этот предел, известный как время Ляпунова, представляет собой глубокую трещину в хрустальном шаре научной теории. Его существование – одна из основных причин, почему научные предсказания носят в лучшем случае вероятностный характер.
Нелинейные уравнения можно далее выделить в подкласс обыкновенных дифференциальных уравнений (ОДУ), которые описывают непрерывные изменения одной переменной, обычно одного измерения в пространстве или во времени. Они используются для отслеживания движения небес, скорости химических реакций в организме и роста инфекций. ОДУ являются подмножеством второй, более крупной группы, известной как уравнения в частных производных (ЧДУ), которые изучают, как вещи изменяются в зависимости от более чем одной переменной, таких как время и пространство, причем последнее можно описать в нескольких измерениях.
Множество ЧДУ. Они возникают в теориях очень большого и очень малого, таких как общая теория относительности и квантовая механика, и отрицают то, как мы понимаем тепло, диффузию, звук, электромагнетизм, гидродинамику и упругость. Например, для описания движения жидкостей мы можем использовать знаменитую систему дифференциальных уравнений в частных производных, разработанную французским инженером и физиком Клодом-Луи Навье (1785–1836) и англо-ирландским физиком и математиком Джорджем Габриелем Стоксом (1819–1903). Уравнения Навье – Стокса используются во всех видах цифровых двойников, например, в потоке жидкости в газовых турбинах88, нефтяных и газовых резервуарах89 и магистралях90, но мы все еще пытаемся раскрыть их математические тайны.
Попытки заставить дифференциальные уравнения работать на виртуальном человеке начались с исследований электрического состояния и электрофизиологических свойств клеток, которые на протяжении веков вызывали восхищение, если не вдохновение. В начале XIX в. Мэри Шелли (урожденная Мэри Годвин), написавшая «Франкенштейна», знала об ужасных публичных демонстрациях, в которых электричество использовалось для реанимации конечностей и тел, извлеченных из виселицы. Точно так же, как грубое применение электродов для оживления мертвых очаровывало ученых ее времени, столетия спустя исследовательское сообщество будет столь же увлечено исследованиями аксона, нитевидной части нервной клетки, которая проводит импульсы, в данном случае позволяющей двигаться кальмару91. Это стало первым шагом на пути к созданию виртуального человека.
От атомов к импульсам
Благодаря достаточно большим нервным волокнам длинноперого прибрежного кальмара эксперименты 1950-х гг. помогли отточить революционную математическую теорию потенциала действия (нервного импульса), которая в 1963 г. принесла британцам Алану Ходжкину и Эндрю Хаксли Нобелевскую премию. Их теория представляла поток и разряд – электрический ток по нерву, создаваемый потоком ионов – в форме нелинейного дифференциального уравнения. Ходжкин шутил, что награда должна была достаться кальмару92.
Работая в Кембриджском университете, Ходжкин и Хаксли показали, как в ответ на стимул отдельные нервные клетки распространяют потенциалы действия, генерируемые быстрым выбросом ионов через нервную клетку. Несмотря на то, что потенциал действия мимолетен и длится несколько тысячных долей секунды, в соседних мембранах он вызывает движение ионов, подобное волне. Согласно стандартному описанию93, потенциал действия распространяется к нервному окончанию, где запускает высвобождение сигнального химического вещества или нейромедиатора.
Нервы, как и другие клетки, сообщаются с окружающей средой через каналы в мембранах посредством потока ионов металлов. Теперь мы знаем, что каналы представляют собой огромные и сложные белки, которые находятся внутри клеточной мембраны и избирательно и быстро транспортируют ионы. Когда через клеточную мембрану прикладывались потенциалы (напряжения), Ходжкин и Хаксли измерили токи и связали их с движением ионов натрия и калия.
Рассматривая мембрану как своего рода электрический конденсатор, Ходжкин и Хаксли смогли использовать теорию электрических цепей для разработки математической модели – набора из четырех обыкновенных дифференциальных уравнений, которые связаны (имеют общие переменные) и описывают четыре переменные, контролирующие изменение состояния клетки с течением времени. Эти «переменные состояния» включают течение тока через клеточную мембрану, а также активацию калиевых и натриевых каналов и дезактивацию натриевых каналов, каждое из которых можно изучить экспериментально. Кроме того, модель содержит набор параметров, настраиваемых для наилучшего соответствия тому, как напряжение на клеточной мембране меняется со временем. По сути, именно так создаются все подобные модели в биофизике и биохимии.
Их модель элегантным и эмпирическим способом отражает связь между ионными каналами и результирующим измеримым электрическим током, протекающим через клеточную мембрану, знаменуя собой первое математическое описание того, что называется возбудимостью клетки94. В своей нобелевской лекции Ходжкин отметил, что «разработанные нами уравнения оказались на удивление мощными». Их расчеты показали хорошее соответствие между предсказанными значениями и остроконечной формой потенциала действия.
Ходжкин и Хаксли не только создали весьма успешную математическую модель сложного биологического процесса, но и подтвердили эту модель последующими детальными молекулярными исследованиями различных трансмембранных белковых каналов, которые позволяют ионам перемещаться внутрь и вовне клеток. Нет ничего более приятного в науке, чем осознание того, что теория, построенная на экспериментальных наблюдениях и математике, может проложить путь к более глубокому пониманию. Показательно также, что этими пионерами были биофизики, что подчеркивает ценность объединения усилий различных дисциплин. Своей работой Ходжкин и Хаксли невольно начали закладывать основы создания виртуального человека.
Пределы исчисления
Замечательным свидетельством силы математики является то, что ее можно использовать, чтобы показать пределы возможностей компьютерного моделирования (тема третьего шага и нашей следующей главы). Это открытие произошло после вопроса, поставленного в Париже в 1900 г. Давидом Гильбертом (1862–1943), профессором математики из Геттингена, Германия, небольшого университетского городка, воспитавшего потрясающие математические таланты, такие как Карл Фридрих Гаусс (1777–1855), Бернхард Риман (1826–1866), Эмми Нетер (1882–1935) и, конечно же, самого Гильберта, который сформулировал 23 задачи, чтобы вдохновить своих коллег.
Гильберт пришел к поиску ограниченного набора аксиом и правил рассуждения, из которых он мог бы вывести всю математическую истину. Пошаговые процедуры выполнения операций путем слепого применения определенных правил называются алгоритмами, названными в честь латинизированной версии имени Мухаммада ибн Мусы аль-Хорезми, персидского астронома и математика IX в. (и латинского перевода названия его самой известной книги – Algoritmi de numero Indorum («Аль-Хорезми об индуистском искусстве расчета»)).
По словам Гильберта, такого рода поэтапные процедуры должны быть в состоянии доказать истинность вещей и быть «полными», поскольку ни одна истина не выходит за рамки их возможностей. Они также должны быть механическими, то есть настолько четкими, чтобы человеческая субъективность не играла роли. Таким образом, миссия Гильберта легла в основу теории вычислимости – изучения мощности и ограничений алгоритмов.
Вдохновленные Гильбертом, исследователи сделали ряд тревожных открытий об основах математики. В начале 1930-х гг. 25-летний австрийско-чехословацко-американский логик Курт Гёдель (1906–1978) установил, что некоторые математические утверждения неразрешимы, то есть их истинность или ложность нельзя доказать. В каком-то смысле он установил, чего не могут сделать компьютеры95. Он продемонстрировал неизбежность обнаружения логических парадоксов, подобных утверждению «Это предложение ложно». Как заметил английский космолог Джон Барроу (1952–2020): «Если бы мы определили религию как систему мышления, которая содержит недоказуемые утверждения, то есть элемент веры, тогда Гёдель научил нас, что математика не просто религия, но единственная религия, способная себя доказать»96.
Ключевым аспектом программы Гильберта была его так называемая Entscheidungsproblem (проблема принятия решения), полностью сформулированная в 1928 г. Гильберт хотел выяснить, существует ли определенный метод – механический процесс или алгоритм, – который можно применить к любому утверждению и который гарантированно даст правильный ответ на вопрос о том, верно ли это утверждение.
В 1936 г. обескураживающий ответ пришел от 24-летнего английского математика Алана Тьюринга (1912–1954). Его статья On Computable Numbers – одна из самых известных в истории исчисления. В ней описано абстрактное устройство, подобное старомодной пишущей машинке, способное решить проблему Гильберта и эквивалентное любой машине, разработанной для вычисления определенного алгоритма97. Это привело к концепции универсальной машины Тьюринга, которая может выполнять любой алгоритм, точно так же, как современный компьютер может выполнять любую программу. Таким образом, Тьюринг придал исчислению математическое значение.
Решение Entscheidungsproblem предполагает разработку компьютерной программы, которая может проверять вторую программу и решать, завершится последняя или будет «зацикливаться». Тьюринг показал, что общая проблема невычислима и выходит за рамки любой компьютерной программы, какой бы сложной она ни была (мы обсуждаем почему в нашей книге 1995 г. Frontiers of Complexity). Работая независимо в Принстоне в 1936–1937 гг., американский логик Алонзо Чёрч98 пришел к тем же выводам, что и американец польского происхождения Эмиль Пост в Городском колледже Нью-Йорка99. Результат очевиден: математику нельзя описать какой-либо конечной системой аксиом.
Когда Гильберт умер в 1943 г., на его надгробии в Геттингене была высечена цитата «Wir müssen Wissen, Wir werden Wissen» («Должны знать, и будем знать») – слова, которые Гильберт произнес в 1930 г. на ежегодном собрании Общества немецких естествоиспытателей и врачей в ответ на латинскую максиму «Ignoramus et ignorabimus» («Не знаем, и не узнаем»). Однако тезис Чёрча – Тьюринга больше соответствует духу последнего: существуют аспекты нашего мира, которые скрыты от компьютерного моделирования, поскольку они неисчислимы или неалгоритмичны.
Исчисляя реальность
Виртуальный человек зависит от способности компьютеров рассчитывать процессы, происходящие в организме. Однако Тьюринг показал нам, что существуют процессы неисчислимые. Мы не знаем, в какой степени природа неисчислима, но знаем, что примеры таятся в физике. Мы описали один из них в Frontiers of Complexity, обсуждая работу Мэриан Пур-Эль и Яна Ричардса из Университета Миннесоты. Они доказали, что существуют невычислимые решения известных уравнений математической физики100, в частности волнового уравнения, которое описывает распространение света в пространстве и времени (то есть электромагнитное излучение), но применимо ко всем видам волн, от тех, которые разбиваются о берег, до звуковых.
Для представления волны в математической форме требуется уравнение в частных производных второго порядка как в пространстве, так и во времени, где вторая производная по времени (ускорение амплитуды волны) связана с кривой, которая является второй производной амплитуды в пространстве. Вы можете найти это волновое уравнение в работе Джеймса Клерка Максвелла (1831–1879), чрезвычайно влиятельного шотландского физика-математика (и вдохновителя Эйнштейна), который произвел революцию в нашем понимании электрических полей, магнитных полей и распространения света, рентгеновских лучей и другого электромагнитного излучения. Пур-Эль и Ричардс показали, что для некоторых классов исчислимых начальных условий101 решения волнового уравнения в более поздние моменты времени неисчислимы102.
Однако, хотя эти решения и недоступны цифровому компьютеру, они могут быть вычислены с помощью простого аналогового компьютера, который опирается на постоянно изменяющиеся свойства реального мира, а не на ограниченные строки из единиц и нулей арифметики с плавающей запятой. Например, чтобы сложить 5 и 9, простые аналоговые компьютеры могли бы сложить напряжения, куски дерева или количество жидкости, соответствующие этим числам, а затем мгновенно получить ответ 14. Когда дело доходит до исчисления волновых уравнений света, аналоговые вычисления знакомы каждому, кто носил очки, пользовался микроскопом или телескопом: это можно сделать с помощью линзы.
Рассмотрим классическое электромагнитное поле, подчиняющееся уравнениям Максвелла. Для некоторых классов вычислимых начальных условий Пур-Эль и Ричардс показали, что поле можно сфокусировать так, что его интенсивность в точке фокуса возможно измерить с помощью простого аналогового устройства, даже если ни на одном цифровом компьютере оно вычислению не поддается. Это не означает, что цифровой компьютер не даст ответа. Даст, но будет невозможно оценить, насколько он близок к правильному, не используя аналоговое устройство или без нахождения точного математического решения.
В биологии тоже есть неисчислимые процессы. По мнению британского лауреата Нобелевской премии и математика Роджера Пенроуза, сознание не занимается исчислениями: мы сами можем сделать вывод об истинности или ложности утверждений, которые лежат за пределами досягаемости алгоритмов – наше мышление содержит неалгоритмические и неисчислимые ингредиенты103. В борьбе за разработку общего искусственного интеллекта это замечательное открытие, опубликованное в книге «Новый ум короля» 1989 г.104, было тихо проигнорировано.
Дополнительное понимание ограничений алгоритмического мышления пришло от Стюарта Кауфмана и его коллег из Института системной биологии в Сиэтле105. Люди могут использовать ситуативное рассуждение – они принимают точки зрения, выбирают цели и могут справиться с информацией, которая является нерелевантной, неполной, двусмысленной и/или противоречивой. Они способны видеть «аффордансы» (возможности) в своем окружении. Люди видят или переживают что-то, получая смутное понимание предназначения вещи или явления. Блок цилиндров двигателя может привести автомобиль в движение, но человек знает, что он также может послужить «причудливым (но эффективным) пресс-папье».
Команда утверждает, что ключевое различие между следующими правилам машинами Тьюринга и нами заключается в том, что алгоритмы не могут идентифицировать и использовать новые возможности. Одна из причин успеха ИИ заключается в том, что он создан для конкретной задачи или цели. Но, как обнаружил Гёдель на примере математики, всегда будут аспекты человеческого интеллекта, которые не могут быть охвачены формальной моделью, основанной на правилах: «Выявление и использование аффордансов выходит за рамки алгоритмических вычислений». Чтобы конкурировать с людьми, общему искусственному интеллекту нужно нечто большее, чем просто индукция, дедукция и абдукция, и он «должен знать, чего хочет, следовательно, должен быть способен вообще чего-то хотеть». Когда дело доходит до опасений, что развитие общего ИИ может поставить под угрозу само наше существование, ученые приходят к утешительному выводу: «Ни одна машина не захочет заменить нас, поскольку ни одна машина ничего не захочет, по крайней мере, в нынешних алгоритмических рамках определения машины».
Проблема цифровых компьютеров
Есть еще одна проблема, связанная с цифровыми компьютерами и поднятая в работе Тьюринга: числа, которыми эти компьютеры манипулируют. То, что Тьюринг называл «вычислимыми числами», – это те числа, с которыми может справиться машина Тьюринга. К ним относятся рациональные числа, повседневные числа, которые можно увидеть на ценниках, размерах обуви, рецептах и многом другом, например целые числа (включая отрицательные), а также дроби, которые можно выразить как отношения целых чисел.
Но есть еще класс иррациональных чисел, которые нельзя выразить как отношение двух целых чисел. Примеры иррациональных чисел: π, длина окружности диаметром 1 (единица) и e – число Эйлера, которое используется в логарифмах, для вычисления сложных процентов и повсеместно встречается в науке и технике. Хотя некоторые иррациональные числа – например, π или квадратный корень из 2 – можно вычислить с помощью алгоритма с любой степенью точности, подавляющее большинство иррациональных чисел неисчислимы.
Это проблематично, поскольку в море всех возможных чисел количество вычислимых рациональных чисел бесконечно мало. Да, существует множество рациональных чисел, которые «исчислимы», но со времен немецкого математика Георга Кантора (1845–1918) мы знаем, что множество иррациональных чисел бесконечно в более широком смысле, будучи «неисчислимо бесконечным».
Открытия Кантора встретили враждебность со стороны его коллег, даже со стороны христианских богословов, которые видели в них вызов Богу. Напротив, Кантор (как и другие до и после) думал, что он действительно увидел разум Бога106. Его работа, уже давно признанная, показывает, что, манипулируя только вычислимыми числами, цифровые компьютеры могут пренебречь более богатыми и глубокими возможностями, открывающимися при использовании бесконечно большего набора невычислимых чисел. Если внимательно посмотреть на цифры, населяющие цифровые компьютеры, вас ждут новые потрясения.
Флопсы
Текущие усилия по моделированию виртуального человека опираются на обычные или классические компьютеры, в которых математические операции (сложение, вычитание и т. д.) выполняются над строками из единиц и нулей ограниченной длины. Они известны как числа с плавающей запятой. Все они являются рациональными числами, гибкими (отсюда и «плавающая запятая»), и были разработаны, чтобы позволить компьютерам манипулировать числами совершенно разных масштабов, от размаха спиральной галактики на сотни тысяч световых лет до человеческого роста и размера клеточных ионных каналов в несколько нанометров в поперечнике. Хотя разница или ошибка в измерении размера галактики в несколько миллиардных долей метра не так важна, она может иметь огромное значение, когда дело касается молекул жизни.
Эти гибкие числа с плавающей запятой состоят из трех частей: цифры, известные как мантисса; порядок – показатель степени, показывающий, где находится запятая; и знаковый бит, который равен 0 для положительного числа и 1 – для отрицательного. В компьютере они выражаются в двоичном формате, так что мантисса состоит из 23 бит, порядок – из 8 бит, плюс знаковый бит (рис. 11). Большинство современных компьютеров используют «числа с плавающей запятой одинарной точности IEEE», которые относятся к техническому стандарту, установленному Институтом инженеров по электротехнике и электронике в 1950-х гг. Именно поэтому мощность компьютера измеряется во флопсах, что означает количество операций с плавающей запятой в секунду.

Рисунок 11. Числа с плавающей запятой одинарной и двойной точности
Хотя числа с плавающей запятой состоят в общей сложности из 32 битов и дают число 232 (всего около четырех миллиардов), существуют также числа двойной точности, которые манипулируют 64 битами и предлагают гораздо больше чисел: 264. Существуют еще более высокие уровни точности, а также числа половинной точности (всего 16 бит), которые стали популярными в машинном обучении для преодоления ограничений памяти и повышения скорости.
Поскольку компьютеры полагаются на арифметику с плавающей запятой, существующую уже несколько десятилетий, они крайне неэффективны. Джон Густафсон из Национального университета Сингапура/A*STAR любит шутить, что числа с плавающей запятой IEEE – это «орудие разрушения математики»107. Он отмечает, что, если организовать свой рабочий день так, как это делает компьютер, который требует непропорционально много усилий для перемещения данных, вы бы ехали на работу четыре часа, работали пять минут, а затем тратили еще четыре часа на дорогу домой. Как следствие, на сложение 64-битных чисел расходуется 0,2 миллиардных джоуля энергии, а на чтение 64 бит из памяти – 12 миллиардных долей джоуля.
Чтобы преодолеть эту «стену памяти» и перемещать только значимые данные, Густафсон разработал универсальный формат чисел – unum, – который дает более точные ответы, чем арифметика с плавающей запятой, но зачастую использует меньше битов, экономя память, пропускную способность, энергию и мощность108. Густафсон также предложил аппаратную версию unum, являющуюся развитием формата чисел с плавающей запятой, называемую posits: «Если алгоритм выдержал испытание временем как стабильный и „достаточно хороший“ с использованием чисел с плавающей запятой, то с позитами он будет работать еще лучше».
Однако на данный момент компьютеры ограничены набором рациональных чисел с плавающей запятой. Как это ограничивает нашу способность моделировать мир?
Трудности перевода
Прежде чем мы сможем смоделировать человеческое тело на компьютере, в нашу модель необходимо ввести соответствующие данные. Например, чтобы представить потоки крови, нам нужно превратить плавные, непрерывно меняющиеся давления и скорости в единицы и нули чисел с плавающей запятой (рис. 12).
Например, когда дело доходит до чисел одинарной точности, всю путаницу реальности приходится сводить к четырем миллиардам чисел в диапазоне от плюс до минус «бесконечности» (конечно, не самой бесконечности, а просто «очень большого числа» – примерно 2 в степени –127 или +127). Вы можете уловить больше этой реальности, используя массивы чисел или двойную точность, которая предлагает 16 квинтиллионов различных чисел, но числа с плавающей запятой в этом огромном диапазоне распределены неравномерно. Абсолютно неравномерно.
Числа одинарной точности распределяются экспоненциально, как уменьшающиеся степени 2. Этих чисел между 0,125 и 0,25 существует столько же, сколько между 0,25 и 0,5 или между 0,5 и 1 и т. д. Из четырех миллиардов примерно один скрывается между 0 и 1, еще один – между 0 и –1, а остальные два миллиарда охватывают диапазон от ±1 до ± «бесконечности» (рис. 13).
То, как этот уменьшенный набор чисел может затуманить хрустальный шар компьютерного моделирования, было впервые обнаружено в начале 1960-х гг. в Массачусетском технологическом институте в Кембридже, штат Массачусетс, когда метеоролог Эдвард Лоренц (1917–2008) использовал компьютер размером с письменный стол (LGP-30, или компьютер общего назначения Librascope) для разработки простой модели прогнозирования.

Рисунок 12. Превращение аналогового сигнала в цифровой
Лоренц пытался смоделировать атмосферу Земли с помощью набора трех связанных обыкновенных дифференциальных уравнений (упрощенных уравнений Навье – Стокса), описывающих конвекцию – движение жидкости, которое можно наблюдать в кастрюле с кипящей водой или чашке горячего кофе. Но когда он попытался повторить свою первоначальную симуляцию, он получил другие результаты. При ближайшем рассмотрении Лоренц обнаружил, что различия возникли из-за крошечной ошибки округления чисел, введенных в его компьютер.

Рисунок 13. Числа с плавающей запятой отражают лишь небольшую часть математической реальности
Можно подумать, что небольшая ошибка привела бы к небольшой разнице. Но реальность была шокирующей: результаты сильно расходились, даже если менялся последний десятичный знак. Однако эти явно случайные колебания возникают из-за детерминистских законов, управляемых дифференциальными уравнениями, а это означает, что результат полностью определяется вводимыми числами.
Его наблюдения о чувствительности хаотических систем в конечном итоге привели Лоренца к формулировке того, что стало известно как «эффект бабочки» – что отражено в названии статьи, которую он представил в 1972 г.: «Предсказуемость: вызывает ли взмах крыльев бабочки в Бразилии торнадо в Техасе?»109. С тех пор предпринимаются усилия по исследованию, пониманию и укрощению динамического хаоса.
От аттракторов к ансамблям
Математический объект, столь же полезный, сколь и красивый, стал символом хаоса, средством его понимания и даже использования. В своей модели конвекции Лоренц выделил три ключевых фактора влияния: изменение температуры сверху вниз и из стороны в сторону, а также скорость конвекции. Он мог отображать эти свойства, отслеживая их момент за моментом.
Работая с Эллен Феттер, Лоренц обнаружил отличительную черту хаоса. Точно так же, как погода имеет закономерности (проявляющиеся в виде смены времен года от лета к зиме), но сильно варьируется изо дня в день (в Лондоне это определенно так), они обнаружили, что и точка в целом прослеживает траекторию в форме бабочки, но при этом никогда не идет по одному и тому же пути по «крыльям».
Даже начав с наименее различных стартовых точек, вы всегда окажетесь на разных треках по мере того, как компьютер движется вперед во времени: две точки аттрактора, которые изначально лежат рядом друг с другом, в конечном итоге оказываются экспоненциально далеко. Однако, какой бы ни была отправная точка, в конечном итоге вы оказываетесь в ловушке общей формы бабочки, состоящей из множества траекторий110.
Чтобы понять весь масштаб того, что может произойти в хаотической динамической системе, необходимо исследовать поведение этой формы бабочки для всех – или как можно большего числа – начальных условий. Результирующий набор симуляций, начинающийся с совокупности начальных условий, называется ансамблем. Этот подход тесно связан с тем, который использовал Больцман для расчета возникновения температуры и других объемных или макроскопических свойств из микроскопического – молекулярного – описания материи, скажем, скорости молекул воды, что дало начало целому направлению, известному как статистическая механика111.
В этом случае ансамбль создается путем моделирования всей системы молекул воды – скажем, наполненного чайника – и последующего повторения этого процесса огромное количество раз с использованием разных начальных условий. Хотя вы можете вычислить температуру на основе кинетической энергии, связанной с движением всех различных молекул воды в каждой «копии» чайника, термодинамическая температура будет средней по ансамблю, а именно средней по каждой из реплик – идея, предложенная американцем Дж. Уиллардом Гиббсом (1838–1903).

Рисунок 14. Ансамблевое прогнозирование. Адаптировано из The Quiet Revolution of Numerical Weather Prediction Питера Бауэра, Алана Торпа и Гилберта Брюне (Nature, 2015)
Ансамбли также фигурировали в некоторых из первых моделей поведения атомов, использовавшихся для моделирования цепных ядерных реакций, к которым мы вернемся в следующей главе. Сегодня они широко используются, особенно в прогнозировании погоды, где слегка отличающиеся начальные условия и значения неопределенных параметров вводятся в модели прогнозирования, чтобы охватить диапазон возможных ожидаемых погодных явлений, например, когда может случиться ураган. Первый прогон кода, чрезвычайно чувствительного к начальным условиям, даст ответы, отличные от следующего. Однако важно отметить, что ансамблевые расчеты действительно дают, как кажется, надежные средние значения.
Английский физик Тим Палмер, работая с Джеймсом Мерфи в Метеорологическом бюро Великобритании, более 25 лет назад подготовил первый в мире вероятностный прогноз погоды, основанный на ансамблях112. Они обнаружили, что если прогнозы сильно различаются по ансамблю, их необходимо хеджировать с точки зрения значительных неопределенностей, тогда как если они похожи, уверенность в результате возрастает.

Рисунок 15. Аттрактор Лоренца (Шуньчжоу Ван, Центр вычислительных наук, UCL)
Таким образом, хаос можно измерить количественно. Вычисляя свойства ансамбля, мы переходим от ненадежных попыток детерминистического описания к надежному, но вероятностному описанию, выраженному в терминах средних значений и стандартных отклонений. Однако математика также показывает нам, почему хаос невозможно полностью укротить.
Странные аттракторы
Математическая картина в форме бабочки, которую мы описали выше, представляет собой аттрактор Лоренца, где термин «аттрактор» означает состояние, к которому динамическая система стремится независимо от начального состояния, и где динамическая система включает все, что меняется во времени, от качающегося маятника до человека или даже популяции, растущей в соответствии с определенным математическим соотношением. Например, когда речь идет об управляемых (то есть далеких от равновесия) динамических системах, говорят, что шарик, который катится и останавливается на дне чаши, достиг устойчивого равновесия, называемого аттрактором с неподвижной точкой. Между тем ритмы клеток сердца улавливаются так называемым периодическим аттрактором. Однако, поскольку крылья бабочки Лоренца не принадлежат ни к одному из этих типов аттракторов, они получили название странного (или хаотического) аттрактора.
Это запоминающееся прозвище придумал бельгийский физик-математик Давид Рюэль вместе с голландским математиком Флорисом Такенсом113. Странный аттрактор имеет так называемую фрактальную геометрию – термин, предложенный франко-американским математиком Бенуа Мандельбротом (1924–2010), – которая обладает свойством самоподобия. Увеличьте масштаб следов странного аттрактора, и вы увидите, что они следуют по схожим, но не идентичным траекториям и орбитам. Увеличьте масштаб еще раз, и вы увидите ту же картину. И так до бесконечности.
Знакомые примеры фрактальных объектов – цветная капуста или брокколи романеско, где, приближая фотографию соцветия, вы видите уменьшенную версию того же самого соцветия. Фракталы таятся и внутри нас: от колебаний ритма здорового сердца до распределения крови в системе кровообращения, структуры дыхательных путей в легких и нейронов114.
Работа Лоренца также открыла альтернативный способ описания хаоса турбулентности в теле, поскольку странный аттрактор улавливает хаотическую сущность текущей жидкости, хотя и требует бесконечных измерений (вместо трех). Точно так же, как сложное музыкальное произведение можно разбить на чистые ноты, так и турбулентность можно выразить через бесконечное число периодических орбит. Турбулентность может показаться беспорядочной, но странный аттрактор предполагает, что жидкость исследует фрактальное гнездо орбит. Несмотря на то, что он называется аттрактором, на самом деле он состоит из орбит, на которых жидкость никогда не задерживается надолго: орбиты неустойчивы, будучи по своей природе одновременно притягивающими и отталкивающими, так что в турбулентных потоках жидкость движется как бы хаотично с одной орбиты на другую. В результате эти нестабильные периодические орбиты можно рассматривать как фундаментальные единицы турбулентности, подобно тому, как простые вибрации являются фундаментальными единицами любых нот, исполняемых на музыкальном инструменте. Предраг Цвитанович из Технологического института Джорджии в Атланте называет эти орбиты «скелетом хаоса»115. В следующей главе мы увидим, как Питер, чтобы разблокировать турбулентность, использовал их как отмычку.
 ), Xiao, Q. (
 ), Zhu, Q. (
 ) & Pan, G. (
 ). Pulsed-jet propulsion of a squid-inspired swimmer at high Reynolds number. Phys. Fluids 32, 111901 (2020).
The free sample has ended.


